Tilbage til udviklingshub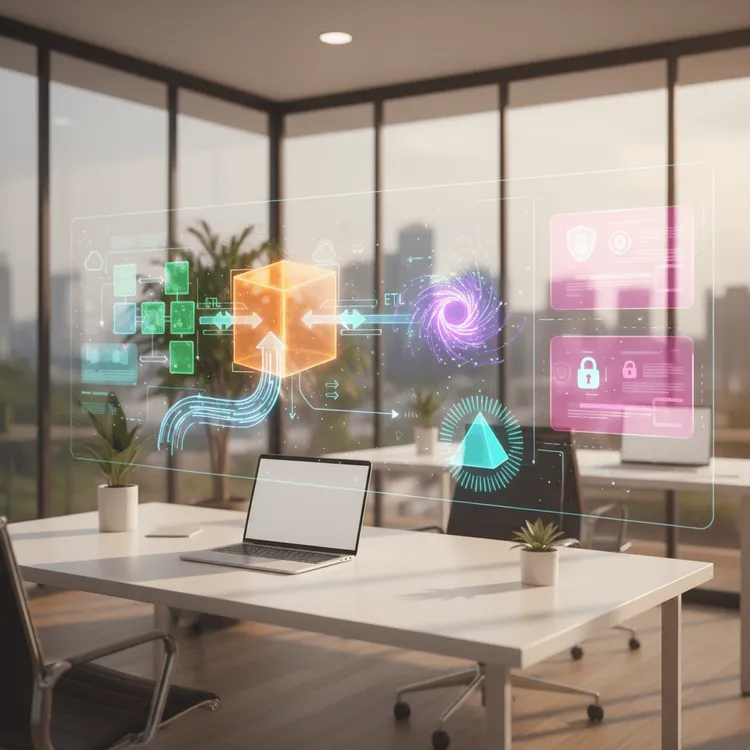
Cloud Data & AI
AWS Data Engineering & AI/ML (SageMaker)
AWS data engineering og AI/ML-tjenester med SageMaker. Byg datapipelines, træn modeller, og implementer ML i stor skala med AWS-native data- og AI-tjenester.
Kom i gang10+
Datapipelines bygget
45%
Gns. omkostningsbesparelser
1TB+
Data behandlet
99.5%
Modelnøjagtighed
Servicekategori
AWS Data & AI Engineering
Ideel til
Datadrevne virksomheder, der bygger analyseplatforme, ML-pipelines eller GenAI-funktioner på AWS.
Tidslinje
4 – 10 uger
Hvorfor vælge MicrocosmWorks til AWS Data & AI?
AWS tilbyder det bredeste sæt af data- og ML-tjenester, men at vælge de rigtige og forbinde dem effektivt kræver dyb ekspertise. Vi designer end-to-end dataplatforme på AWS — fra indtagelsespipelines og data lakes til modeltræning med SageMaker og real-time inferens-slutpunkter — alt sammen med korrekt governance og omkostningskontrol.
Vores AWS Data & AI-kapaciteter
- Data Lake-arkitektur — Design S3-baserede data lakes med Lake Formation governance, Glue-kataloger og Athena til serverless analytics.
- ETL-pipelineudvikling — Byg skalerbare datapipelines ved hjælp af Glue, Step Functions og Kinesis til batch- og real-time databehandling.
- SageMaker ML-platform — Opsæt end-to-end ML-arbejdsgange: data labeling, modeltræning, hyperparameter tuning og modelimplementering med SageMaker.
- Real-Time ML-inferens — Implementer modeller som real-time slutpunkter, batch transform jobs eller serverless inferens med auto-scaling og A/B testing.
- Data Governance — Implementer datakvalitetskontroller, lineage tracking, adgangskontroller og compliance tagging på tværs af dataplatformen.
- GenAI-integration — Integrer Bedrock foundation models og brugerdefinerede finjusterede modeller i produktionsapplikationer med RAG-mønstre.
AWS-specifik teknologistak
Vi bygger på AWS's dataøkosystem: S3 og Lake Formation til lagring, Glue og Kinesis til behandling, Redshift og Athena til analyse, SageMaker til ML og Bedrock til generativ AI — alt orkestreret med Step Functions og overvåget med CloudWatch og SageMaker Model Monitor.
Hvem dette er for
Datadrevne virksomheder, der ønsker at bygge analyseplatforme, ML-pipelines eller GenAI-funktioner på AWS. Uanset om du starter din datarejse eller skalerer en eksisterende ML-drift, bringer vi arkitekturekspertisen til at maksimere ROI fra dine datainvesteringer.
Vores proces
1
Dataanalyse
Optælle datakilder, vurdere kvalitet, definere analysekrav og identificere ML-muligheder.
2
Platformarkitektur
Design data lake-arkitektur, pipeline-topologi, ML-arbejdsgang og governance-ramme.
3
Pipelineimplementering
Byg indtagelsespipelines, transformation jobs, datakvalitetskontroller og katalogstyring.
4
ML-udvikling
Træn modeller, optimer hyperparameters, implementer inferens-slutpunkter og implementer overvågning.
5
Produktionsdrift
Etabler MLOps-praksisser, overvågning af datapipeline, triggere for gentiltræning af modeller og omkostningsstyring.
Teknologisk stak
Data & Lagring
S3Lake FormationRedshiftAthenaGlue
ML & AI
SageMakerBedrockComprehendRekognition
Streaming & ETL
KinesisStep FunctionsGlue ETLEventBridge
Governance
Lake FormationCloudWatchDataBrewData Quality
Industrier vi betjener
FinTechSundhedssektorenDetailhandelAd TechLogistikProduktion
Klar til at bygge på AWS Data & AI?
Lad os arkitektere din dataplatform og ML-pipeline på AWS — fra rå data til produktionsmodeller.
Ofte stillede spørgsmål
MicrocosmWorks specialiserer sig i SageMaker til modeltræning og -udrulning, Glue og EMR til ETL, Redshift og Athena til analyse, Kinesis til streaming og Step Functions til ML pipeline-orkestrering på tværs af hele data engineering-livscyklussen.
AWS SageMaker og data engineering konsulentydelser er tilgængelige for $30-$50 i timen, dækkende opsætning af pipelines til modeltræning, udrulning af endpoints, feature stores og integration med din eksisterende datainfrastruktur.
Ja, vi bygger produktions-ML-pipelines ved hjælp af SageMaker Pipelines med automatiseret dataforbehandling, distribueret træning, hyperparameter tuning, model evaluering, model registry og A/B-testimplementering med real-time og batch inference endpoints.
Absolut. MicrocosmWorks designer S3-baserede datasøer med Glue crawlers, ETL jobs og Data Catalog, implementerer Lake Formation til styring og bygger feature engineering pipelines, der fører direkte ind i SageMaker training jobs.
Ja, vi implementerer brugerdefinerede og open source LLM'er på SageMaker ved hjælp af Deep Learning Containers, konfigurerer inference endpoints med model parallelism til store modeller og integrerer med AWS Bedrock for hybridarkitekturer, der kombinerer proprietære og foundation models.