De fleste søgebokse findes for at besvare ét spørgsmål: hvad matcher de ord, jeg har indtastet? Det er det rigtige spørgsmål for et bibliotekskatalog. Det er det forkerte spørgsmål for en ernæringsapp.
Når en bruger åbner opskriftssiden i Appetec, er de ord, de indtaster, den mindst interessante del af anmodningen. Det, der faktisk betyder noget, er usynligt: kalorier tilbage i dag, hvad de har lavet uge efter uge uden at tænke over det, om de er veganere, og om de allerede har sprængt deres budget inden aftensmaden. En søgemaskine, der ignorerer alt dette, vil med glæde returnere opskrifter, der matcher — og lige så gladeligt sabotere grunden til, at brugeren åbnede appen. Dette er arkitekturen bag et mønster bygget til at lukke det hul: relevans, der er rigtig for denne person, lige nu.
Hvorfor tekstmatch alene ikke er nok
Mønsteret gælder, når den samme forespørgsel skal returnere forskellige resultater for forskellige brugere — når "bedst" afhænger af kontekst, brugeren aldrig indtastede, og når kataloget, du ejer, er mindre end det katalog, dine brugere forventer. Personlig opsøgning behandler relevans som en blanding af tre signaler i stedet for ét:
| Signal | Hvad det fanger |
|---|---|
| Tekst | Hvad brugeren indtastede — eller, i måltids-scan-tilstand, hvad der blev detekteret på deres tallerken |
| Målpasning | Hvor godt en opskrift passer til de kalorier, brugeren har tilbage til dette måltid, i dag |
| Vane | Hvor ofte denne specifikke bruger faktisk spiser denne opskrift |
En naiv motor ser kun den første række i den tabel. Dette mønster smelter alle tre sammen til en enkelt rangeret liste og efterfylder derefter fra en ekstern kilde, når det lokale katalog løber tør — og udvider stille og roligt kataloget, hver gang det sker. Resultatet føles mindre som at forespørge en database og mere som en ven, der allerede kender dit køkken og din kost.
Hvordan pipelinen er sat sammen
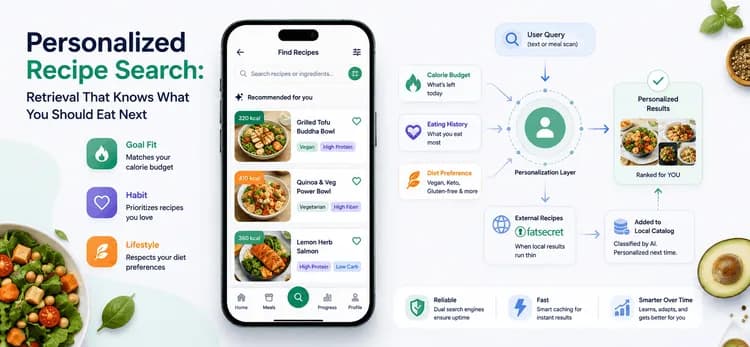
Systemet kører som en retrieval pipeline med et personaliseringslag foran og et selvhelende katalog bagved.
To søgemaskiner, én kontrakt. Elasticsearch er primær: fuzzy tastefejlstolerance, engelsk stammereduktion ("grill" finder "grilled"), vægtet relevansscoring. Hvis den nogensinde er utilgængelig, falder den samme forespørgsel igennem til en MongoDB-søgning, der respekterer de samme filtre og personaliseringsregler. Søgningen forringes ved fejl; den forsvinder aldrig.
Laget, som brugerne mærker, men aldrig ser. Før resultaterne returneres, omformer tre ting listen. Kaloriebudgettet beregnes ud fra det daglige mål minus det, der er logget, hvilket booster opskrifter, der passer til det resterende vindue — og hvis brugeren har overskredet sit mål, sorteres listen stille og roligt lavest-kalorie-først, hvilket skubber mod genopretning i stedet for overbærenhed. Spisehistorik destillerer de sidste 60 dages måltidslogfiler til et "hvad du faktisk spiser"-kort, der holder favoritter ét tryk væk på side et. Kostpræference — veg, vegan, non-veg, plus to dusin finere tags som keto, gluten-free og high-protein — filtrerer og rangerer alt nedenunder igen.
Et katalog, der vokser af sig selv. Når lokale resultater er få, henter pipelinen fra en ekstern kilde, FatSecret, og fletter disse resultater ind i det samme uendeligt-scroll-feed uden synlige sømme. Den skriver derefter disse eksterne opskrifter tilbage i det lokale katalog og bruger en LLM til at klassificere hver som veg, non-veg eller vegan, så den kan personaliseres korrekt næste gang — den samme instinkt bag en hybrid retrieval arkitektur, vi har anvendt andre steder, hvor lokale og eksterne resultater skal føles som ét system.
Tre caches, tre jobs. Kombinerede resultatssæt, det per-bruger vane-kort og eksterne API-svar har hver deres uafhængige levetid, så en personaliseret forespørgsel fra flere kilder stadig returneres med omtrent samme hastighed som et enkelt almindeligt opslag.
Afvejninger værd at nævne
Intet af dette kom gratis, og at være ærlig omkring omkostningerne er en del af det, der gør mønsteret troværdigt snarere end bare smart.
Relevans blev bevidst gjort u-neutral. En ren tekstrelevansrangering er "fair" på en måde, der aktivt er unyttig her. Resultater er bevidst partiske mod målpasning og vane, fordi en opskrift, der er lidt mindre tekstuelt perfekt, men som passer til nogens budget og smag, er det bedre svar. "Hvorfor rangerede denne først?" bliver en produktbeslutning, ikke en søgemaskine-standard — hvilket er grunden til, at disse vægte lever i applikationskode, ikke en uovervåget konfigurationsfil.
At eje hele kataloget var ikke målet — at eje den rigtige del af det var. Ekstremerne, der blev overvejet, var et fuldt kurateret katalog (høj kvalitet, snæver bredde) eller en fuld proxy til en ekstern API (ubegrænset bredde, nul kontrol, nul personalisering). Systemet deler forskellen: Før an med ejede og bruger-forfattede opskrifter, efterfyld eksternt, når det er nødvendigt, og absorber det, der efterfyldes — tendensen, over tid, er at eje præcis det, brugerne faktisk søger efter.
Resiliens blev valgt frem for maksimal effektivitet. To fulde søgemaskiner koster mere at drive end én — den samme resiliens-først-tankegang bag de fleste af vores backend-beslutninger. Den omkostning blev bevidst accepteret: opskriftssøgning er kernen i daglig brugsfunktionalitet, hvor forringet søgning er en mindre irritation, men manglende søgning er en ødelagt app.
Personalisering koster forudsigelighed. Resultater adskiller sig faktisk efter tidspunkt på dagen, forbrugte kalorier og historik — selv for den samme bruger til morgenmad versus aftensmad. Det er tilsigtet, men det hæver barren for test og support: "det virker på min telefon" betyder ikke meget længere, når korrekthed defineres per-bruger, per-øjeblik.
Hvornår dette mønster passer — og hvornår det ikke gør
Det er værd at være klar over, hvor dette mønster ikke bør bruges. Det fortjener sin kompleksitet, når resultaterne virkelig skal afvige per bruger baseret på kontekst, de aldrig har indtastet, når det ejede katalog er mindre, end hvad brugerne forventer, men kan beriges eksternt, når funktionen er hyppig nok til, at gradvis nedgradering betyder mere end minimal infrastruktur, og når "relevans" legitimt inkluderer signaler ud over tekst.
Det er det forkerte værktøj, når resultaterne er identiske for hver bruger — en offentlig dokumentsøgning, et SKU-opslag — hvor personalisering tilføjer omkostninger uden udbytte. Det er unødvendigt, når kataloget er lille og stabilt nok til, at en enkelt motor med simpel filtrering er tilstrækkelig, og det arbejder imod dig, hvor som helst streng, identisk, fuldt forklarlig rangering er et ufravigeligt krav.
Den faktiske opgave
Retrieval-kvalitet her behandles som et personaliseringsproblem, ikke kun et matchningsproblem. En opskriftssøgning, der er tekstuelt perfekt, men ignorerer, at brugeren er veganer, allerede har overskredet budgettet og har lavet de samme fem middage hele måneden, virkede teknisk set, men fejlede praktisk talt. Opgaven var aldrig at finde opskrifter, der matcher forespørgslen — det er at præsentere den opskrift, denne person skal lave næste gang. Hvert lag af denne arkitektur, fra de dobbelte søgemaskiner til den stille omskiftning, når nogen har overskredet budgettet, eksisterer for at lukke det hul.
Hvis du overvejer en lignende beslutning om at bygge eller integrere for søgning eller retrieval i dit eget produkt, taler vi gerne det igennem.
Andre blogs
1. Skalering af en digital sundhedsplatform med Microservices