Karamihan sa mga search box ay umiiral upang sagutin ang isang tanong: ano ang tumutugma sa mga salitang aking inilagay? Iyan ang tamang tanong para sa isang catalog ng aklatan. Ito ay maling tanong para sa isang nutrition app.
Kapag binuksan ng user ang pahina ng mga resipe sa Appetec, ang mga salitang kanilang inilagay ay ang pinakakaunting-interesanteng bahagi ng kahilingan. Ang talagang mahalaga ay hindi nakikita: mga calories na natira ngayong araw, kung ano ang kanilang niluto linggo-linggo nang hindi nag-iisip, kung sila ay vegan, at kung nalampasan na nila ang kanilang budget bago maghapunan. Ang isang search engine na binabalewala ang lahat ng iyon ay masayang magbibigay ng mga resipe na tumutugma — at kasing-saya ring sisirain ang dahilan kung bakit binuksan ng user ang app. Ito ang arkitektura sa likod ng isang pattern na binuo upang isara ang puwang na iyon: kaangkupan na tama para sa taong ito, ngayon.
Bakit Hindi Sapat ang Pagtutugma Lamang ng Teksto
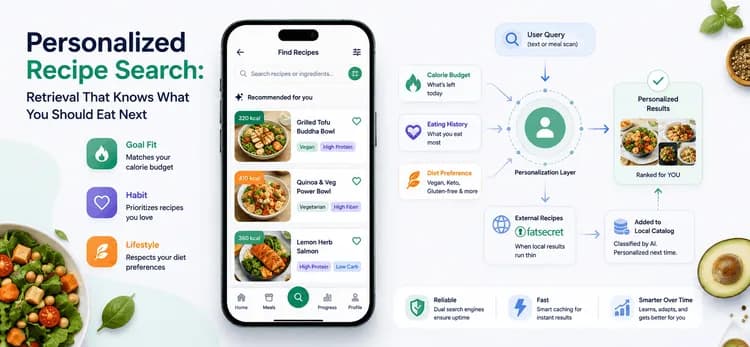
Ang pattern na ito ay nalalapat tuwing ang parehong query ay dapat magbalik ng iba't ibang resulta para sa iba't ibang user — kapag ang "pinakamahusay" ay nakasalalay sa konteksto na hindi kailanman inilagay ng user, at kapag ang catalog na iyong pag-aari ay mas maliit kaysa sa catalog na inaasahan ng iyong mga user. Ang personalizadong paghahanap ng resipe ay tinuturing ang kaangkupan bilang pinagsamang tatlong signal sa halip na isa:
| Signal | Ano ang Sinasakop Nito |
|---|---|
| Teksto | Ang inilagay ng user — o, sa meal-scan mode, ang natukoy sa kanilang plato |
| Pagkasyang sa layunin | Gaano kahusay ang isang resipe sa mga calories na natira ng user para sa pagkain na ito, ngayong araw |
| Gawi | Gaano kadalas kinakain ng partikular na user na ito ang resipe na ito |
Ang isang simpleng engine ay nakikita lamang ang unang hilera ng talahanayang iyon. Pinagsasama ng pattern na ito ang lahat ng tatlo sa isang solong listahan na may ranggo, pagkatapos ay nagpupuno mula sa isang panlabas na source tuwing kumakaunti ang lokal na catalog — tahimik na pinapalaki ang catalog na iyon sa bawat pagkakataon. Ang resulta ay parang hindi pagtatanong sa isang database at mas parang isang kaibigan na alam na ang iyong kusina at ang iyong diyeta.
Paano Binuo ang Pipeline
Ang sistema ay tumatakbo bilang isang retrieval pipeline na may personalization layer sa harap at isang self-healing catalog sa likod nito.
Dalawang search engine, isang kontrata. Ang Elasticsearch ang pangunahin: fuzzy typo tolerance, English stemming ("grill" ay nakakahanap ng "grilled"), weighted relevance scoring. Kung ito ay hindi available, ang parehong query ay awtomatikong lumilipat sa isang MongoDB search na sumusunod sa parehong mga filter at personalization rule. Ang paghahanap ay bumababa ang kalidad sa ilalim ng pagkabigo; hindi ito kailanman nawawala.
Ang layer na nararamdaman ng mga user ngunit hindi nila nakikita. Bago bumalik ang mga resulta, tatlong bagay ang nagpapabago sa listahan. Ang budget ng calories ay kinakalkula mula sa pang-araw-araw na target minus ang naitala, pinapalakas ang mga resipe na akma sa natitirang window — at kung nalampasan na ng user ang kanilang target, tahimik na inaayos muli ng listahan ang pinakamababang-calorie-muna, nagtutulak patungo sa pagbawi sa halip na indulhensiya. Ang kasaysayan ng pagkain ay nagdadalisay sa huling 60 araw ng meal logs sa isang "kung ano ang talagang kinakain mo" na mapa, pinapanatili ang mga paborito sa isang tap lang sa unang pahina. Ang kagustuhan sa diyeta — veg, vegan, non-veg, kasama ang dalawang dosenang mas detalyadong tags tulad ng keto, gluten-free, at high-protein — ay nagsasala at nagre-rank ng lahat ng nasa ilalim.
Isang catalog na lumalago sa sarili. Kapag kumakaunti ang mga lokal na resulta, ang pipeline ay kumukuha mula sa isang panlabas na source, ang FatSecret, pinagsasama ang mga resultang iyon sa parehong infinite-scroll feed nang walang nakikitang dugtong. Pagkatapos ay isinusulat nito ang mga panlabas na resipe pabalik sa lokal na catalog, gamit ang isang LLM upang uriin ang bawat isa bilang veg, non-veg, o vegan, upang ito ay tama na mapersonalize sa susunod — ang parehong instinct sa likod ng isang hybrid retrieval architecture na inilapat namin sa ibang lugar, kung saan ang lokal at panlabas na resulta ay kailangang magmukhang isang sistema.
Tatlong cache, tatlong trabaho. Ang pinagsamang set ng resulta, ang per-user habit map, at ang mga external-API response ay bawat isa ay may sariling independiyenteng lifetime, kaya ang isang personalized, multi-source query ay bumabalik pa rin sa bilis ng isang solong plain lookup.
Ang mga Kompromiso na Dapat Banggitin
Wala sa mga ito ang dumating nang libre, at ang pagiging tapat tungkol sa gastos ay bahagi ng kung ano ang nagiging dahilan upang maging mapagkakatiwalaan ang pattern sa halip na matalino lamang.
Sadyang ginawang hindi neutral ang kaangkupan. Ang isang purong text-relevance ranking ay "makatarungan" sa paraan na aktibong walang silbi dito. Sadyang may bias ang mga resulta patungo sa pagkasyang sa layunin at gawi, dahil ang isang resipe na bahagyang hindi perpekto sa teksto ngunit akma sa budget at panlasa ng isang tao ay ang mas mahusay na sagot. Ang "Bakit ito ang unang niranggo?" ay nagiging desisyon ng produkto, hindi isang search-engine default — kaya't ang mga timbang na iyon ay nasa application code, hindi isang hindi pag-aaring config file.
Hindi layunin ang pagmamay-ari ng buong catalog — ang pagmamay-ari sa tamang bahagi nito ang layunin. Ang mga labis na pinag-isipan ay isang ganap na curated na catalog (mataas na kalidad, makitid na saklaw) o isang buong proxy sa isang external API (walang limitasyong saklaw, walang kontrol, walang personalization). Hinahati ng sistema ang pagkakaiba: pinangungunahan ng pag-aari at user-authored na mga resipe, nagpupuno mula sa labas kung kinakailangan, at sinisipsip ang napunan — nagte-trend, sa paglipas ng panahon, patungo sa pagmamay-ari ng eksaktong hinahanap ng mga user.
Pinili ang Resilience kaysa sa peak efficiency. Ang dalawang buong search engine ay mas mahal patakbuhin kaysa sa isa — ang parehong resilience-first thinking sa likod ng karamihan ng aming mga desisyon sa backend. Sadyang tinanggap ang gastos na iyon: ang paghahanap ng resipe ay pangunahing, pang-araw-araw na pag-andar, kung saan ang degraded search ay isang maliit na abala ngunit ang nawawalang search ay isang sirang app.
Ang Personalization ay may katumbas na kawalan ng predictability. Tunay na nagkakaiba ang mga resulta ayon sa oras ng araw, calories na nakonsumo, at kasaysayan — kahit para sa parehong user sa almusal kumpara sa hapunan. Iyon ay sinadya, ngunit pinapataas nito ang pamantayan para sa pagsubok at suporta: ang "gumagana ito sa aking telepono" ay hindi na gaanong kahulugan kapag ang pagiging tama ay tinukoy per-user, per-moment.
Kailan Angkop ang Pattern na Ito — at Kailan Hindi
Mahalagang maging malinaw tungkol sa kung saan hindi dapat gamitin ang pattern na ito. Nakakamit nito ang pagiging kumplikado nito kapag ang mga resulta ay talagang dapat magkaiba per user batay sa konteksto na hindi nila kailanman inilagay, kapag ang pag-aaring catalog ay mas maliit kaysa sa inaasahan ng mga user ngunit maaaring mapayaman sa labas, kapag ang feature ay sapat na madalas gamitin na mas mahalaga ang graceful degradation kaysa sa minimal na imprastraktura, at kapag ang "relevance" ay lehitimong kasama ang mga signal bukod sa teksto.
Ito ay maling tool kapag ang mga resulta ay magkapareho para sa bawat user — isang public docs search, isang SKU lookup — kung saan ang personalization ay nagdaragdag ng gastos nang walang benepisyo. Hindi ito kinakailangan kapag ang catalog ay maliit at sapat na matatag upang ang isang solong engine na may simpleng filtering ay sapat na, at ito ay laban sa iyo kahit saan kung saan ang mahigpit, magkapareho, ganap na naipapaliwanag na ranking ay isang mahirap na kinakailangan.
Ang Tunay na Gawain
Ang kalidad ng retrieval dito ay itinuturing bilang isang problema sa personalization, hindi lamang isang problema sa pagtutugma. Ang isang paghahanap ng resipe na perpekto sa teksto ngunit binabalewala na ang user ay vegan, nalampasan na ang budget, at niluto ang parehong limang hapunan sa buong buwan ay technically gumana ngunit practically nabigo. Ang gawain ay hindi kailanman upang maghanap ng mga resipe na tumutugma sa query — ito ay upang ipakita ang resipe na dapat lutuin ng taong ito sa susunod. Bawat layer ng arkitekturang ito, mula sa dual search engine hanggang sa tahimik na pag-re-sort kapag nalampasan ng isang tao ang budget, ay umiiral upang isara ang puwang na iyon.
Kung ikaw ay nagtatimbang ng katulad na desisyon sa build-vs-blend para sa search o retrieval sa iyong sariling produkto, masaya kaming pag-usapan ito.
Iba Pang Blog
1. Pagpapalaki ng isang Digital Health Platform gamit ang Microservices
2. Pag-sync ng Apple Health at Health Connect
3. Pag-optimize ng Channel Logo para sa Iba't Ibang Video Resolution