Bumalik sa Development Hub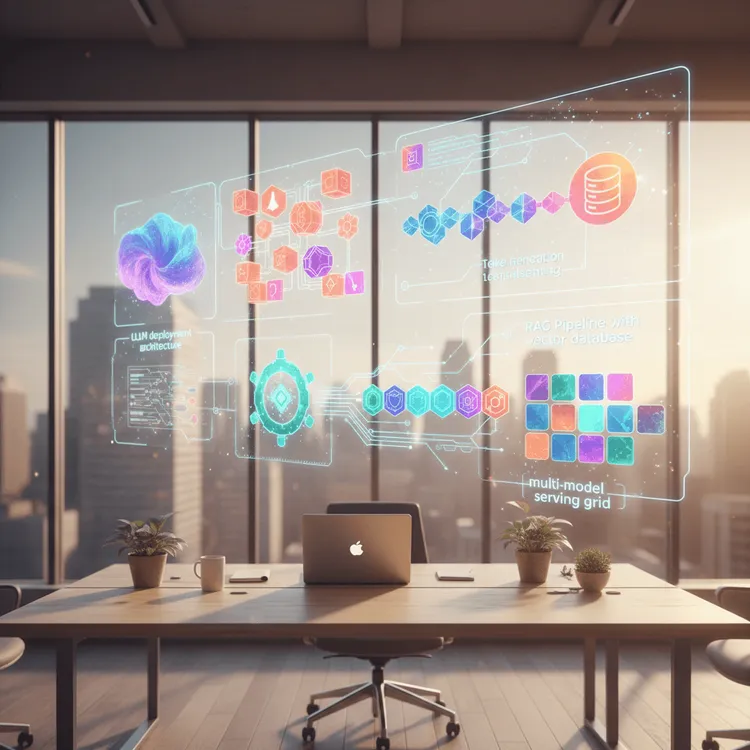
Cloud Data & AI
RunPod para sa Pag-deploy ng LLM at AI Model
I-deploy ang mga LLM at AI model sa RunPod na may na-optimize na pipeline ng inference. Isinaayos namin ang vLLM, Triton, at pasadyang solusyon sa pagse-serve para sa production-grade na AI.
Magsimula75+
구축된 데이터 파이프라인
45%
평균 비용 절감
10PB+
처리된 데이터
99.5%
모델 정확도
Kategorya ng Serbisyo
Pag-deploy ng RunPod AI
Perpekto Para sa
Mga kumpanya ng AI na nagde-deploy ng mga LLM, diffusion model, o custom na AI model sa RunPod na nangangailangan ng na-optimize na pipeline ng inference.
Takdang Panahon
4 – 12 linggo

Bakit Piliin ang MicrocosmWorks para sa Pag-deploy ng LLM sa RunPod?
Ang pag-deploy ng malalaking language model at AI model sa production ay nangangailangan ng espesyal na kadalubhasaan — mula sa pagpili ng tamang GPU instance at mga diskarte sa quantization hanggang sa pagbuo ng mga pipeline ng inference na may mababang latency. Tinutulungan namin ang mga kumpanya ng AI na i-deploy ang mga model sa RunPod na may na-optimize na imprastraktura ng pagse-serve na nagbabalanse sa gastos, latency, at throughput para sa real-world na traffic ng production.
Ang Aming Mga Kakayahan sa Pag-deploy ng RunPod LLM
- Pagse-serve ng LLM gamit ang vLLM — I-deploy ang mga open-source na LLM gamit ang vLLM na may PagedAttention para sa maximum na throughput at minimal na latency sa mga RunPod GPU.
- Triton Inference Server — I-set up ang NVIDIA Triton para sa multi-model na pagse-serve na may dynamic batching, model ensemble pipeline, at GPU sharing.
- Model Quantization — Ilapat ang GPTQ, AWQ, at GGUF quantization upang bawasan ang laki ng model at gastos sa inference nang walang makabuluhang pagkasira ng kalidad.
- Custom Model Endpoints — Bumuo ng mga RunPod Serverless endpoint na may custom handler para sa iyong partikular na arkitektura ng model at pangangailangan sa preprocessing.
- Multi-Model Architectures — Magdisenyo ng mga system na nagruruta ng mga request sa iba't ibang variant ng model batay sa kumplikado, gastos, o mga kinakailangan sa latency.
- A/B Testing at Canary Deployments — Magpatupad ng unti-unting rollout strategy para sa mga bagong bersyon ng model na may awtomatikong pagsubaybay sa kalidad.
Technology Stack na Tiyak sa RunPod
Nagde-deploy kami ng mga model gamit ang vLLM, NVIDIA Triton Inference Server, at custom na FastAPI endpoint sa RunPod Pods at Serverless GPU. Kasama sa aming stack ang PyTorch, Hugging Face Transformers, CUDA optimizations, at TensorRT para sa maximum na performance ng inference. Pinapares namin ito sa auto-scaling ng RunPod para sa cost-efficient na production serving.
Para Kanino Ito
Ang serbisyong ito ay para sa mga kumpanya ng AI na nagde-deploy ng mga LLM, diffusion model, o custom na AI model na nangangailangan ng production-grade na inference sa RunPod. Kung ikaw man ay nagse-serve ng isang fine-tuned na Llama model, isang custom na vision model, o isang multi-modal pipeline, naghahatid kami ng na-optimize na deployment na nakakatugon sa iyong mga kinakailangan sa latency at throughput.
Aming Proseso
1
탐색
모델 아키텍처, 추론 요구사항, 지연 시간 목표 및 트래픽 패턴을 분석합니다.
2
아키텍처 설계
GPU 선택, 양자화 전략 및 스케일링 구성을 포함한 서빙 인프라를 설계합니다.
3
구현
vLLM 또는 Triton을 사용하여 모델을 배포하고, 맞춤형 엔드포인트를 구축하며, RunPod Serverless를 구성합니다.
4
최적화
지연 시간 및 처리량을 벤치마킹하고, Flash Attention 및 배치 전략과 같은 최적화를 적용합니다.
5
운영
모델 버전 관리, A/B 테스트 파이프라인, 모니터링 및 자동 스케일링 정책을 설정합니다.
Teknolohiyang Stack
Model Serving
vLLMTritonTensorRTFastAPI
AI Frameworks
PyTorchHugging FaceCUDAONNX
RunPod Platform
RunPod PodsServerless GPUCustom HandlersNetwork Volumes
Optimization
GPTQAWQFlash AttentionKV Cache
Mga Industriyang Aming Pinaglilingkuran
AI 및 머신러닝SaaS 제품헬스케어 AI리갈 테크콘텐츠 생성대화형 AI
Handa nang I-deploy ang Iyong mga AI Model sa RunPod?
Kumuha ng tulong ng eksperto sa pag-deploy ng iyong mga LLM at AI model sa RunPod na may na-optimize na imprastraktura ng pagse-serve na binuo para sa production scale.
Mga Madalas Itanong
Oo, ini-deploy ng MicrocosmWorks ang mga open-source na LLM kabilang ang Llama 3, Mistral, Mixtral, Qwen, at iba pang mga modelo sa RunPod gamit ang mga na-optimize na inference server tulad ng vLLM, TGI, o TensorRT-LLM para sa pinakamataas na throughput at pinakamababang latency.
Para sa mga modelong may 7B-13B na parameter, karaniwan naming inirerekomenda ang mga pod ng A40 o RTX 4090. Para sa mga modelong 70B+, kino-configure namin ang mga pod ng A100 80GB o H100 na may tensor parallelism, at para sa mga workload na sensitibo sa gastos, inia-set up namin ang mga quantized model sa mga lower-tier na GPU.
Nagcha-charge ang MicrocosmWorks ng $25-$50 kada oras para sa LLM deployment consulting at setup sa RunPod, na kinabibilangan ng inference server optimization, API endpoint configuration, load testing, at dokumentasyon. Karamihan sa mga deployment ay natatapos sa loob ng 20-40 oras.
Oo, kino-configure namin ang mga OpenAI-compatible na API endpoint gamit ang vLLM o katulad na mga server sa RunPod Serverless, na nagbibigay-daan sa drop-in replacement ng mga tawag sa OpenAI API sa iyong self-hosted na modelo, kabilang ang streaming, function calling, at chat completion formats.
Tiyak. I-de-deploy ng MicrocosmWorks ang mga fine-tuned na LoRA adapter at mga ganap na pinagsamang custom na modelo sa RunPod, at isinasama ang mga ito sa mga RAG pipeline gamit ang mga vector database tulad ng Qdrant o Weaviate para sa henerasyong pinalawig ng konteksto gamit ang iyong proprietary data.