صُممت معظم مربعات البحث للإجابة على سؤال واحد: ما الذي يتطابق مع الكلمات التي كتبتها؟ هذا هو السؤال الصحيح لفهرس مكتبة. إنه السؤال الخاطئ لتطبيق تغذية.
عندما يفتح المستخدم صفحة الوصفات في Appetec، تكون الكلمات التي يكتبونها هي الجزء الأقل أهمية من الطلب. ما يهم حقًا غير مرئي: السعرات الحرارية المتبقية لليوم، ما طبخوه أسبوعًا بعد أسبوع دون التفكير فيه، ما إذا كانوا نباتيين (vegan)، وما إذا كانوا قد تجاوزوا ميزانيتهم بالفعل بحلول العشاء. سيعيد محرك البحث الذي يتجاهل كل ذلك بكل سرور وصفات متطابقة — وبنفس السعادة سيعرقل السبب الذي جعل المستخدم يفتح التطبيق. هذه هي البنية وراء نمط مصمم لسد هذه الفجوة: الملاءمة المناسبة لهذا الشخص، في هذه اللحظة.
لماذا لا يكفي التطابق النصي وحده
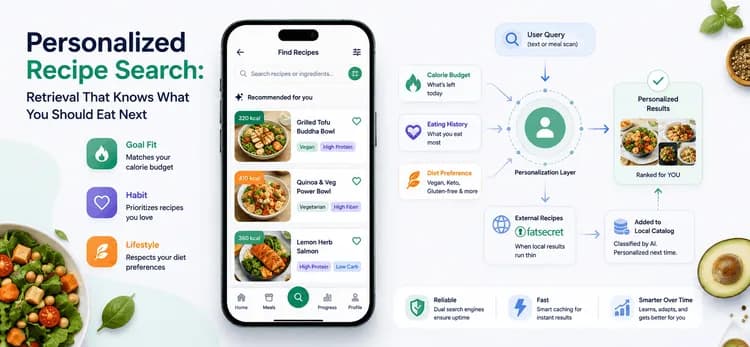
ينطبق هذا النمط كلما كان من المفترض أن تعيد نفس الاستعلام نتائج مختلفة لمستخدمين مختلفين — عندما تعتمد "الأفضلية" على سياق لم يكتبه المستخدم أبدًا، وعندما يكون الكتالوج الذي تملكه أصغر من الكتالوج الذي يتوقعه مستخدموك. يتعامل بحث الوصفات المخصص مع الملاءمة كمزيج من ثلاث إشارات بدلاً من إشارة واحدة:
| إشارة | ما يلتقطه |
|---|---|
| نص | ما كتبه المستخدم — أو، في وضع مسح الوجبات، ما تم اكتشافه في طبقه |
| ملاءمة الهدف | مدى ملاءمة الوصفة للسعرات الحرارية المتبقية للمستخدم لهذه الوجبة، اليوم |
| عادة | كم مرة يتناول هذا المستخدم تحديدًا هذه الوصفة فعليًا |
يرى المحرك البدائي الصف الأول فقط من هذا الجدول. يدمج هذا النمط الإشارات الثلاث في قائمة مرتبة واحدة، ثم يملأ البيانات من مصدر خارجي كلما نفد الكتالوج المحلي — وينمو هذا الكتالوج بصمت في كل مرة يحدث فيها ذلك. تبدو النتيجة أقل شبهاً بالاستعلام عن قاعدة بيانات وأكثر شبهاً بصديق يعرف مطبخك ونظامك الغذائي بالفعل.
كيف يتم تجميع خط الأنابيب (Pipeline)
يعمل النظام كـ retrieval pipeline مع personalization layer أمامي و self-healing catalog خلفي.
محركا بحث، عقد واحد. Elasticsearch هو الأساسي: يتضمن fuzzy typo tolerance، و English stemming ("grill" يجد "grilled")، و weighted relevance scoring. إذا أصبح غير متاح في أي وقت، ينتقل نفس الاستعلام إلى بحث MongoDB الذي يحترم نفس عوامل التصفية وقواعد التخصيص. يتدهور البحث عند الفشل؛ لكنه لا يختفي أبدًا.
الطبقة التي يشعر بها المستخدمون ولكن لا يرونها أبدًا. قبل عودة النتائج، تعيد ثلاثة أشياء تشكيل القائمة. يتم حساب ميزانية السعرات الحرارية من الهدف اليومي مطروحًا منه ما تم تسجيله، مما يعزز الوصفات التي تتناسب مع أي نافذة متبقية — وإذا تجاوز المستخدم هدفه، تعيد القائمة ترتيب نفسها بصمت بحيث تكون الوصفات الأقل سعرات حرارية أولاً، للدفع نحو التعافي بدلاً من الإفراط. يلخص سجل الأكل آخر 60 يومًا من سجلات الوجبات في خريطة "ما تأكله فعليًا"، مما يبقي المفضلة بنقرة واحدة على الصفحة الأولى. تفضيلات الحمية الغذائية — مثل veg، vegan، non-veg، بالإضافة إلى عشرين علامة أدق مثل keto، gluten-free، و high-protein — تقوم بتصفية وإعادة ترتيب كل شيء أسفل ذلك.
كتالوج ينمو ذاتيًا. عندما تنفد النتائج المحلية، ينتقل خط الأنابيب (pipeline) إلى مصدر خارجي، FatSecret، لدمج تلك النتائج في نفس موجز التمرير اللانهائي (infinite-scroll feed) دون أي تفاوت مرئي. ثم يكتب تلك الوصفات الخارجية مرة أخرى في الكتالوج المحلي، باستخدام LLM لتصنيف كل منها على أنها veg أو non-veg أو vegan، بحيث يمكن تخصيصها بشكل صحيح في المرة القادمة — وهو نفس الدافع وراء hybrid retrieval architecture الذي طبقناه في أماكن أخرى، حيث يجب أن تبدو النتائج المحلية والخارجية كنظام واحد.
ثلاثة مخابئ (caches)، ثلاث وظائف. مجموعات النتائج المدمجة، وخريطة العادات لكل مستخدم، واستجابات API الخارجية، يحمل كل منها عمره المستقل، لذا فإن الاستعلام المخصص والمتعدد المصادر لا يزال يعود بنفس سرعة البحث البسيط تقريبًا.
المقايضات الجديرة بالذكر
لم يأتِ أي من هذا مجانًا، والصدق بشأن التكلفة هو جزء مما يجعل هذا النمط جديرًا بالثقة بدلاً من مجرد كونه ذكيًا.
تم جعل الملاءمة غير محايدة عمدًا. إن ترتيب الملاءمة النصية البحتة "عادل" بطريقة غير مفيدة هنا بشكل فعال. تم تحيز النتائج نحو ملاءمة الهدف والعادة عمدًا، لأن وصفة أقل مثالية من الناحية النصية بقليل ولكنها تناسب ميزانية شخص ما وذوقه هي الإجابة الأفضل. يصبح سؤال "لماذا احتلت هذه الوصفة المرتبة الأولى؟" قرارًا يتعلق بالمنتج، وليس افتراضيًا لمحرك البحث — ولهذا السبب توجد تلك الأوزان في كود التطبيق، وليس في ملف config غير مملوك.
لم يكن امتلاك الكتالوج بأكمله هو الهدف — بل امتلاك الجزء الصحيح منه هو الهدف. كانت الأطراف القصوى التي تم النظر فيها هي كتالوج منسق بالكامل (جودة عالية، نطاق ضيق) أو وكيل كامل لـ API خارجي (نطاق غير محدود، صفر تحكم، صفر تخصيص). يقسم النظام الفرق: يقود بالوصفات المملوكة والمعدة من قبل المستخدمين، ويملأ من مصادر خارجية عند الحاجة، ويستوعب ما يتم ملؤه — يتجه، بمرور الوقت، نحو امتلاك ما يبحث عنه المستخدمون بالفعل.
تم اختيار المرونة على حساب الكفاءة القصوى. يكلف تشغيل محركي بحث كاملين أكثر من محرك واحد — وهو نفس resilience-first thinking وراء معظم قراراتنا المتعلقة بالـ backend. تم قبول هذه التكلفة عن عمد: بحث الوصفات هو وظيفة أساسية، للاستخدام اليومي، حيث يكون البحث المتدهور إزعاجًا طفيفًا ولكن فقدان البحث يعني تطبيقًا معطلًا.
التخصيص يكلف القدرة على التنبؤ. تختلف النتائج حقًا حسب وقت اليوم، والسعرات الحرارية المستهلكة، والسجل — حتى لنفس المستخدم عند الإفطار مقابل العشاء. هذا مقصود، لكنه يرفع مستوى الاختبار والدعم: يصبح قول "يعمل على هاتفي" بلا معنى كبير عندما يتم تعريف الصلاحية لكل مستخدم، وفي كل لحظة.
متى يناسب هذا النمط — ومتى لا يناسب
تجدر الإشارة بوضوح إلى المواضع التي لا ينبغي استخدام هذا النمط فيها. يكتسب هذا النمط تعقيده عندما يجب أن تختلف النتائج حقًا لكل مستخدم بناءً على سياق لم يكتبوه أبدًا، وعندما يكون الكتالوج المملوك أصغر مما يتوقعه المستخدمون ولكن يمكن إثراؤه خارجيًا، وعندما تكون الميزة متكررة بما يكفي لدرجة أن graceful degradation يهم أكثر من البنية التحتية الدنيا، وعندما تتضمن "الملاءمة" إشارات مشروعة تتجاوز النص.
إنه الأداة الخاطئة عندما تكون النتائج متطابقة لكل مستخدم — مثل بحث مستندات عام، أو بحث SKU — حيث يضيف التخصيص تكلفة بدون عائد. وهو غير ضروري عندما يكون الكتالوج صغيرًا ومستقرًا بما يكفي لمحرك واحد مع تصفية بسيطة، ويعمل ضدك في أي مكان يكون فيه الترتيب الصارم، المتطابق، والقابل للتفسير بالكامل مطلبًا صارمًا.
الوظيفة الفعلية
تُعامل جودة الاسترجاع هنا كمشكلة تخصيص، وليس مجرد مشكلة تطابق. بحث الوصفات الذي يكون مثاليًا نصيًا مع تجاهل أن المستخدم vegan، وتجاوز ميزانيته بالفعل، وطبخ نفس الوجبات الخمس طوال الشهر، نجح من الناحية التقنية وفشل عمليًا. لم تكن الوظيفة أبدًا هي العثور على وصفات تتطابق مع الاستعلام — بل هي إظهار الوصفة التي يجب على هذا الشخص طهيها بعد ذلك. كل طبقة من هذه البنية، من محركي البحث المزدوجين إلى إعادة الترتيب الهادئة عندما يتجاوز شخص ما ميزانيته، موجودة لسد هذه الفجوة.
إذا كنت توازن بين قرار مماثل لبناء أو دمج (build-vs-blend) للبحث أو الاسترجاع في منتجك الخاص، يسعدنا مناقشة الأمر معك.
مدونات أخرى
1. توسيع نطاق منصة صحية رقمية باستخدام Microservices