La mayoría de las cajas de búsqueda existen para responder a una pregunta: ¿qué coincide con las palabras que escribí? Esa es la pregunta correcta para un catálogo de biblioteca. Es la pregunta incorrecta para una aplicación de nutrición.
Cuando un usuario abre la página de recetas en Appetec, las palabras que escribe son la parte menos interesante de la solicitud. Lo que realmente importa es invisible: las calorías que quedan hoy, lo que han cocinado semana tras semana sin pensarlo, si son veganos y si ya han excedido su presupuesto para la cena. Un motor de búsqueda que ignora todo eso devolverá felizmente recetas que coinciden — y con la misma felicidad saboteará la razón por la que el usuario abrió la aplicación. Esta es la arquitectura detrás de un patrón construido para cerrar esa brecha: relevancia que es adecuada para esta persona, ahora mismo.
Por Qué la Coincidencia de Texto Sola No es Suficiente
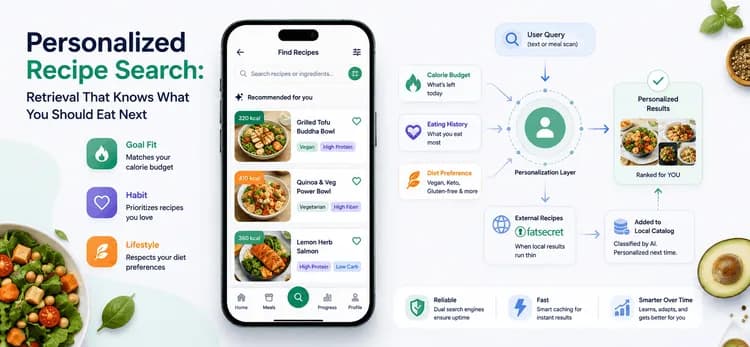
El patrón se aplica siempre que la misma consulta debería devolver diferentes resultados para diferentes usuarios — cuando "mejor" depende del contexto que el usuario nunca escribió, y cuando el catálogo que posees es más pequeño que el catálogo que tus usuarios esperan. La búsqueda de recetas personalizadas trata la relevancia como una mezcla de tres señales en lugar de una:
| Señal | Lo que Captura |
|---|---|
| Texto | Lo que el usuario escribió — o, en modo de escaneo de comidas, lo que se detectó en su plato |
| Ajuste de objetivo | Qué tan bien se ajusta una receta a las calorías que el usuario tiene para esta comida, hoy |
| Hábito | Con qué frecuencia este usuario específico realmente come esta receta |
Un motor ingenuo solo ve la primera fila de esa tabla. Este patrón fusiona las tres en una sola lista clasificada, luego rellena desde una fuente externa siempre que el catálogo local se agota — creciendo silenciosamente ese catálogo cada vez que lo hace. El resultado se siente menos como consultar una base de datos y más como un amigo que ya conoce tu cocina y tu dieta.
Cómo se Ensambla la Canalización
El sistema funciona como una canalización de recuperación con una capa de personalización al frente y un catálogo auto-reparable detrás.
Dos motores de búsqueda, un contrato. Elasticsearch es el principal: tolerancia a errores tipográficos, derivación en inglés ("grill" encuentra "grilled"), puntuación de relevancia ponderada. Si alguna vez no está disponible, la misma consulta pasa a una búsqueda en MongoDB respetando los mismos filtros y reglas de personalización. La búsqueda se degrada bajo fallos; nunca desaparece.
La capa que los usuarios sienten pero nunca ven. Antes de que los resultados regresen, tres cosas remodelan la lista. El presupuesto de calorías se calcula a partir del objetivo diario menos lo registrado, impulsando recetas que se ajustan a cualquier ventana que quede — y si el usuario ha sobrepasado su objetivo, la lista se reordena silenciosamente de menor a mayor caloría, inclinándose hacia la recuperación en lugar de la indulgencia. El historial de comidas destila los últimos 60 días de registros de comidas en un mapa de "lo que realmente comes", manteniendo los favoritos a un toque en la primera página. La preferencia dietética — veg, vegano, no veg, además de dos docenas de etiquetas más finas como keto, sin gluten y alta en proteínas — filtra y reordena todo debajo.
Un catálogo que crece por sí mismo. Cuando los resultados locales se agotan, la canalización pasa a una fuente externa, FatSecret, integrando esos resultados en el mismo feed de desplazamiento infinito sin costura visible. Luego escribe esas recetas externas de nuevo en el catálogo local, usando un LLM para clasificar cada una como veg, no veg o vegana, para que sea correctamente personalizable la próxima vez — el mismo instinto detrás de una arquitectura de recuperación híbrida que hemos aplicado en otros lugares, donde los resultados locales y externos deben sentirse como un solo sistema.
Tres cachés, tres trabajos. Los conjuntos de resultados combinados, el mapa de hábitos por usuario y las respuestas de la API externa llevan cada uno su propia vida útil independiente, por lo que una consulta personalizada y de múltiples fuentes aún se devuelve a aproximadamente la velocidad de una sola búsqueda simple.
Las Compensaciones que Vale la Pena Nombrar
Nada de esto fue gratis, y ser honesto sobre el costo es parte de lo que hace que el patrón sea confiable en lugar de solo ingenioso.
La relevancia fue hecha deliberadamente no neutral. Un ranking de relevancia de texto puro es "justo" de una manera que es activamente inútil aquí. Los resultados están sesgados hacia el ajuste de objetivo y el hábito a propósito, porque una receta ligeramente menos perfecta textualmente que se ajusta al presupuesto y gusto de alguien es la mejor respuesta. "¿Por qué esto se clasificó primero?" se convierte en una decisión de producto, no en un defecto del motor de búsqueda — por lo que esos pesos viven en el código de la aplicación, no en un archivo de configuración no gestionado.
Poseer todo el catálogo no era el objetivo — poseer la parte correcta de él sí lo era. Los extremos considerados fueron un catálogo completamente curado (alta calidad, amplitud estrecha) o un proxy completo a una API externa (amplitud ilimitada, cero control, cero personalización). El sistema divide la diferencia: lidera con recetas propias y de usuarios, rellena externamente cuando es necesario, y absorbe lo que se rellena — tendiendo, con el tiempo, a poseer exactamente lo que los usuarios realmente buscan.
La resiliencia fue elegida sobre la eficiencia máxima. Dos motores de búsqueda completos cuestan más operar que uno — el mismo pensamiento de resiliencia primero detrás de la mayoría de nuestras decisiones de backend. Ese costo fue aceptado deliberadamente: la búsqueda de recetas es una funcionalidad central de uso diario, donde la búsqueda degradada es una molestia menor pero la búsqueda ausente es una aplicación rota.
La personalización cuesta previsibilidad. Los resultados realmente difieren según la hora del día, las calorías consumidas y el historial — incluso para el mismo usuario en el desayuno frente a la cena. Eso es intencionado, pero eleva el nivel para las pruebas y el soporte: "funciona en mi teléfono" deja de significar mucho cuando la corrección se define por usuario, por momento.
Cuándo Este Patrón Encaja — y Cuándo No
Vale la pena ser claro sobre dónde este patrón no debería ser utilizado. Gana su complejidad cuando los resultados deberían diferir genuinamente por usuario basado en un contexto que nunca escribieron, cuando el catálogo propio es más pequeño de lo que los usuarios esperan pero puede ser enriquecido externamente, cuando la característica es lo suficientemente frecuente como para que la degradación elegante importe más que la infraestructura mínima, y cuando "relevancia" incluye legítimamente señales más allá del texto.
Es la herramienta incorrecta cuando los resultados son idénticos para cada usuario — una búsqueda de documentos públicos, una búsqueda de SKU — donde la personalización agrega costo sin beneficio. Es innecesario cuando el catálogo es lo suficientemente pequeño y estable como para que un solo motor con filtrado simple sea suficiente, y trabaja en tu contra en cualquier lugar donde un ranking estricto, idéntico y completamente explicable es un requisito estricto.
El Trabajo Real
La calidad de recuperación aquí se trata como un problema de personalización, no solo un problema de coincidencia. Una búsqueda de recetas que sea textualmente perfecta mientras ignora que el usuario es vegano, ya está sobre el presupuesto y ha cocinado las mismas cinco cenas todo el mes técnicamente funcionó y prácticamente falló. El trabajo nunca fue encontrar recetas que coincidan con la consulta — es mostrar la receta que esta persona debería cocinar a continuación. Cada capa de esta arquitectura, desde los motores de búsqueda duales hasta el reordenamiento silencioso cuando alguien está sobre el presupuesto, existe para cerrar esa brecha.
Si estás considerando una decisión similar de construir o mezclar para búsqueda o recuperación en tu propio producto, estamos encantados de hablarlo.
Otros Blogs
1. Escalando una Plataforma de Salud Digital con Microservicios
2. Sincronizando Apple Health & Health Connect
3. Optimizando el Logo del Canal para Diferentes Resoluciones de Video