Retour au Hub de développement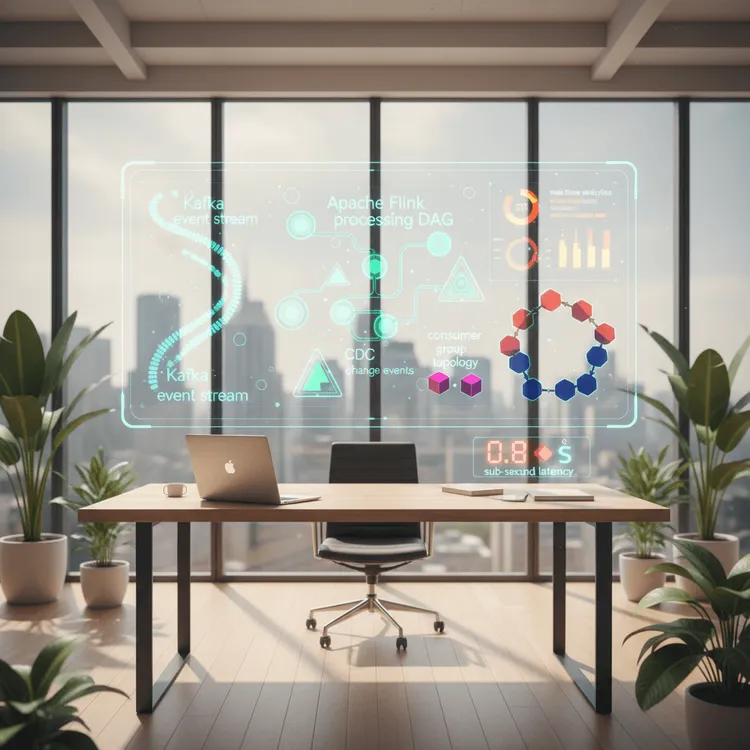
Database & Data
Traitement de Données en Temps Réel
Solutions de traitement et de streaming de données en temps réel. Nous construisons des systèmes événementiels utilisant Kafka, Flink et Spark Streaming pour un traitement de données à l'échelle en moins d'une seconde.
Commencer99.9%
Disponibilité Atteinte
10x
Gains de Vitesse des Requêtes
Zero
Perte de Données
24/7
Support Disponible
Catégorie de service
Ingénierie de Données en Temps Réel
Idéal pour
Applications nécessitant un traitement de données en moins d'une seconde — analyses en direct, détection de fraude, IoT et systèmes événementiels.
Chronologie
4 – 10 semaines

Pourquoi choisir MicrocosmWorks pour le Traitement de Données en Temps Réel ?
Le traitement par lots n'est plus suffisant — les applications modernes ont besoin de données en temps réel. Nous concevons et implémentons des architectures de streaming qui traitent des millions d'événements par seconde avec une latence inférieure à la seconde. De l'ingestion d'événements à l'analyse en temps réel, nous construisons des systèmes qui maintiennent vos données à jour et vos utilisateurs informés.
Nos Capacités de Traitement en Temps Réel
- Architecture de Streaming d'Événements — Conception de systèmes événementiels utilisant Apache Kafka, Redpanda ou des services cloud-native pour un traitement d'événements fiable et ordonné.
- Traitement de Flux — Création de transformations, agrégations et enrichissements en temps réel utilisant Flink, Spark Streaming ou Kafka Streams.
- Analyse en Temps Réel — Création de tableaux de bord en direct, de métriques en temps réel et d'agrégations de streaming qui reflètent l'état de votre entreprise en secondes, et non en heures.
- Event Sourcing & CQRS — Implémentation de systèmes basés sur l'Event Sourcing avec séparation commande/requête pour des pistes d'audit complètes et des capacités de requête temporelle.
- CDC (Change Data Capture) — Mise en place de streaming de changements de base de données avec Debezium pour la synchronisation de données en temps réel entre systèmes.
- Alertes et Détection d'Anomalies — Construction de systèmes de surveillance en temps réel qui détectent les anomalies, déclenchent des alertes et initient des réponses automatisées en quelques secondes.
Pile Technologique
Nous construisons avec Apache Kafka pour le streaming d'événements, Apache Flink pour le traitement de flux stateful, Debezium pour le CDC, et ClickHouse ou Druid pour l'OLAP en temps réel. Déploiement sur Kubernetes avec une gestion appropriée de la contre-pression (backpressure), des sémantiques exactement-une-fois (exactly-once semantics) et une surveillance complète.
À Qui S'adresse Ce Service
Applications nécessitant des données en temps réel — détection de fraude, analyses en direct, traitement IoT, personnalisation en temps réel ou microservices événementiels. Si vos processus par lots introduisent des délais inacceptables, nous concevons des architectures de streaming qui fournissent les données au moment le plus opportun.
Notre processus
1
Analyse des Exigences
Définir les exigences de latence, les sources de données, la logique de traitement et les destinations de sortie.
2
Conception de l'Architecture
Concevoir la topologie de streaming, la stratégie de partitionnement, le pipeline de traitement et les garanties exactement une fois.
3
Implémentation
Construire des producteurs d'événements, des processeurs de streaming, des consommateurs et des tableaux de bord d'analyse en temps réel.
4
Tests et Validation
Tester la charge avec des taux d'événements similaires à la production, valider les garanties d'ordonnancement et tester la récupération après panne.
5
Production et Surveillance
Déployer avec la surveillance du décalage des consommateurs, le suivi de la santé des partitions et des politiques de mise à l'échelle automatisées.
Pile technologique
Streaming
Apache KafkaRedpandaKinesisPulsar
Traitement
Apache FlinkSpark StreamingKafka StreamsKSQL
CDC
DebeziumAWS DMSLogical ReplicationMaxwell
Analyse
ClickHouseApache DruidTimescaleDBGrafana
Industries que nous servons
FinTechAdTechIoTGamingE-CommerceLogistiqueTélécom
Prêt à Traiter Vos Données en Temps Réel ?
Construisons une architecture de streaming qui fournit les données au moment le plus opportun — en temps réel.
Questions fréquemment posées
Nous construisons des pipelines de données en temps réel en utilisant Apache Kafka, Apache Flink, Apache Spark Streaming et AWS Kinesis. Notre choix dépend de vos exigences en matière de latence, de vos besoins de débit et de l'infrastructure existante.
MicrocosmWorks propose le développement de traitement de données en temps réel à $25-$50/heure. Le coût total du projet dépend du volume de données, du nombre de sources, de la complexité du traitement et de si vous avez besoin de garanties de livraison exactement une fois.
Oui, nous concevons des solutions d'analyse en temps réel en utilisant des moteurs de streaming comme Kafka Streams ou Flink combinés à des bases de données de séries temporelles comme ClickHouse ou TimescaleDB, offrant une latence de requête inférieure à la seconde sur des données en direct.
Nous mettons en œuvre des stratégies de fenêtrage avec des watermarks configurables et des seuils de latence autorisée, en utilisant le traitement basé sur le temps de l'événement dans Flink ou Kafka Streams pour gérer correctement les événements désordonnés sans perte de données.
Absolument. MicrocosmWorks est spécialisé dans la construction d'architectures lambda et kappa qui unifient le traitement de flux en temps réel avec les pipelines de traitement par lots existants, assurant des résultats cohérents sur les deux modes de traitement.