Sebagian besar kotak pencarian ada untuk menjawab satu pertanyaan: apa yang cocok dengan kata-kata yang saya ketik? Itu adalah pertanyaan yang tepat untuk katalog perpustakaan. Itu adalah pertanyaan yang salah untuk aplikasi nutrisi.
Ketika pengguna membuka halaman resep di Appetec, kata-kata yang mereka ketik adalah bagian yang paling tidak menarik dari permintaan tersebut. Yang sebenarnya penting adalah hal yang tidak terlihat: sisa kalori hari ini, apa yang mereka masak minggu demi minggu tanpa memikirkannya, apakah mereka vegan, dan apakah mereka sudah melampaui anggaran mereka saat makan malam. Mesin pencari yang mengabaikan semua itu akan dengan senang hati mengembalikan resep yang cocok — dan sama senangnya merusak alasan pengguna membuka aplikasi. Ini adalah arsitektur di balik pola yang dibangun untuk menutup kesenjangan itu: relevansi yang tepat untuk orang ini, saat ini.
Mengapa Pencocokan Teks Saja Tidak Cukup
Pola ini berlaku setiap kali kueri yang sama harus mengembalikan hasil yang berbeda untuk pengguna yang berbeda — ketika "terbaik" bergantung pada konteks yang tidak pernah diketik pengguna, dan ketika katalog yang Anda miliki lebih kecil dari katalog yang diharapkan pengguna Anda. Pencarian resep yang dipersonalisasi memperlakukan relevansi sebagai gabungan dari tiga sinyal, bukan satu:
| Sinyal | Apa yang Ditangkapnya |
|---|---|
| Teks | Apa yang diketik pengguna — atau, dalam mode pemindaian makanan, apa yang terdeteksi di piring mereka |
| Kesesuaian tujuan | Seberapa baik resep sesuai dengan kalori yang tersisa bagi pengguna untuk makanan ini, hari ini |
| Kebiasaan | Seberapa sering pengguna spesifik ini benar-benar memakan resep ini |
Mesin yang naif hanya melihat baris pertama dari tabel itu. Pola ini menggabungkan ketiganya menjadi satu daftar berperingkat, kemudian mengisi kembali dari sumber eksternal setiap kali katalog lokal menipis — secara diam-diam mengembangkan katalog itu setiap kali melakukannya. Hasilnya terasa kurang seperti mengueri database dan lebih seperti seorang teman yang sudah mengenal dapur dan diet Anda.
Bagaimana Pipeline Disusun
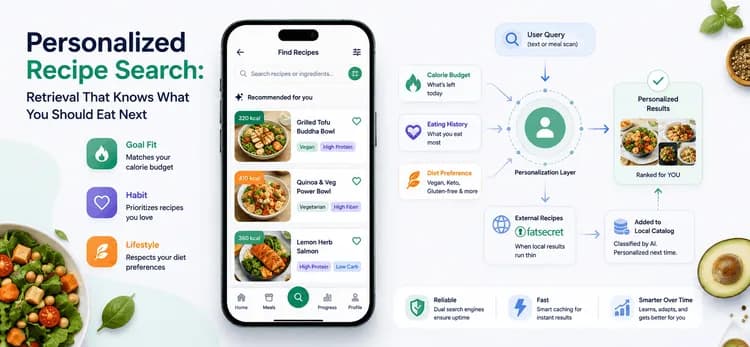
Sistem berjalan sebagai pipeline pengambilan dengan lapisan personalisasi di depan dan katalog yang dapat menyembuhkan diri di belakangnya.
Dua mesin pencari, satu kontrak. Elasticsearch adalah yang utama: toleransi kesalahan ketik fuzzy, stemming bahasa Inggris ("grill" menemukan "grilled"), penilaian relevansi berbobot. Jika sewaktu-waktu tidak tersedia, kueri yang sama akan dialihkan ke pencarian MongoDB yang mematuhi filter dan aturan personalisasi yang sama. Pencarian akan menurun kinerjanya di bawah kegagalan; tidak pernah hilang.
Lapisan yang dirasakan pengguna tetapi tidak pernah terlihat. Sebelum hasil dikembalikan, tiga hal membentuk ulang daftar. Anggaran kalori dihitung dari target harian dikurangi apa yang dicatat, meningkatkan resep yang sesuai dengan sisa jendela — dan jika pengguna telah melampaui target mereka, daftar akan secara diam-diam diurutkan ulang dengan kalori terendah terlebih dahulu, mendorong ke arah pemulihan daripada pemanjaan. Riwayat makan menyaring catatan makanan 60 hari terakhir menjadi peta "apa yang sebenarnya Anda makan", menjaga favorit tetap satu ketukan di halaman pertama. Preferensi diet — veg, vegan, non-veg, ditambah dua lusin tag yang lebih spesifik seperti keto, gluten-free, dan high-protein — menyaring dan mengurutkan ulang semuanya di bawahnya.
Katalog yang tumbuh dengan sendirinya. Ketika hasil lokal menipis, pipeline mengambil dari sumber eksternal, FatSecret, menyatukan hasil tersebut ke dalam feed infinite-scroll yang sama tanpa batas yang terlihat. Kemudian menulis resep eksternal tersebut kembali ke katalog lokal, menggunakan LLM untuk mengklasifikasikan masing-masing sebagai veg, non-veg, atau vegan, sehingga dapat dipersonalisasi dengan benar di lain waktu — insting yang sama di balik arsitektur pengambilan hibrida yang kami terapkan di tempat lain, di mana hasil lokal dan eksternal perlu terasa seperti satu sistem.
Tiga cache, tiga tugas. Set hasil gabungan, peta kebiasaan per pengguna, dan respons API eksternal masing-masing memiliki masa pakai independennya sendiri, sehingga kueri yang dipersonalisasi dari berbagai sumber masih kembali dengan kecepatan kira-kira sama dengan satu pencarian biasa.
Kompromi yang Layak Disebutkan
Tidak ada dari semua ini yang didapat secara gratis, dan bersikap jujur tentang biayanya adalah bagian dari apa yang membuat pola ini dapat dipercaya daripada hanya cerdas.
Relevansi sengaja dibuat tidak netral. Peringkat relevansi teks murni "adil" dengan cara yang secara aktif tidak membantu di sini. Hasil dibiasakan terhadap kesesuaian tujuan dan kebiasaan secara sengaja, karena resep yang sedikit kurang sempurna secara tekstual tetapi sesuai dengan anggaran dan selera seseorang adalah jawaban yang lebih baik. "Mengapa ini menempati peringkat pertama?" menjadi keputusan produk, bukan default mesin pencari — itulah sebabnya bobot tersebut berada dalam kode aplikasi, bukan file konfigurasi yang tidak dimiliki.
Memiliki seluruh katalog bukanlah tujuannya — memiliki bagian yang tepat dari katalog itulah tujuannya. Batas ekstrem yang dipertimbangkan adalah katalog yang sepenuhnya dikurasi (kualitas tinggi, cakupan sempit) atau proxy penuh ke API eksternal (cakupan tak terbatas, nol kontrol, nol personalisasi). Sistem ini mengambil jalan tengah: memimpin dengan resep yang dimiliki dan dibuat pengguna, mengisi kembali secara eksternal saat dibutuhkan, dan menyerap apa yang diisi kembali — tren, seiring waktu, menuju kepemilikan persis apa yang sebenarnya dicari pengguna.
Ketahanan dipilih di atas efisiensi puncak. Dua mesin pencari penuh membutuhkan biaya operasi lebih banyak daripada satu — pemikiran yang mengutamakan ketahanan yang sama di balik sebagian besar keputusan backend kami. Biaya itu diterima secara sengaja: pencarian resep adalah fungsi inti yang digunakan sehari-hari, di mana pencarian yang terdegradasi adalah gangguan kecil tetapi pencarian yang hilang berarti aplikasi rusak.
Personalisasi memakan prediktabilitas. Hasil benar-benar berbeda berdasarkan waktu dalam sehari, kalori yang dikonsumsi, dan riwayat — bahkan untuk pengguna yang sama saat sarapan versus makan malam. Itu memang disengaja, tetapi hal itu meningkatkan standar untuk pengujian dan dukungan: "itu berfungsi di ponsel saya" tidak lagi berarti banyak ketika kebenaran didefinisikan per pengguna, per momen.
Kapan Pola Ini Cocok — dan Kapan Tidak
Penting untuk menjelaskan dengan jelas di mana pola ini seharusnya tidak digunakan. Pola ini layak mendapatkan kompleksitasnya ketika hasil seharusnya benar-benar berbeda per pengguna berdasarkan konteks yang tidak pernah mereka ketik, ketika katalog yang dimiliki lebih kecil dari yang diharapkan pengguna tetapi dapat diperkaya secara eksternal, ketika fitur tersebut cukup sering digunakan sehingga degradasi yang anggun lebih penting daripada infrastruktur minimal, dan ketika "relevansi" secara sah mencakup sinyal di luar teks.
Ini adalah alat yang salah ketika hasilnya identik untuk setiap pengguna — pencarian dokumen publik, pencarian SKU — di mana personalisasi menambah biaya tanpa imbalan. Ini tidak perlu ketika katalog cukup kecil dan stabil sehingga satu mesin dengan pemfilteran biasa sudah cukup, dan itu akan merugikan Anda di mana pun peringkat yang ketat, identik, dan sepenuhnya dapat dijelaskan adalah persyaratan yang sulit.
Tugas Sebenarnya
Kualitas pengambilan di sini diperlakukan sebagai masalah personalisasi, bukan hanya masalah pencocokan. Pencarian resep yang sempurna secara tekstual tetapi mengabaikan bahwa pengguna adalah vegan, sudah melebihi anggaran, dan telah memasak lima makan malam yang sama sepanjang bulan secara teknis berhasil dan secara praktis gagal. Tugasnya tidak pernah untuk menemukan resep yang cocok dengan kueri — melainkan untuk menampilkan resep yang seharusnya dimasak orang ini selanjutnya. Setiap lapisan arsitektur ini, mulai dari mesin pencari ganda hingga pengurutan ulang yang tenang ketika seseorang melebihi anggaran, ada untuk menutup kesenjangan itu.
Jika Anda sedang mempertimbangkan keputusan bangun-vs-padu yang serupa untuk pencarian atau pengambilan di produk Anda sendiri, kami dengan senang hati membahasnya.
Blog Lainnya
1. Menskalakan Platform Kesehatan Digital dengan Microservices