10+
Data Pipelines Built
45%
Cost Savings Avg
1TB+
Data Processed
99.5%
Model Accuracy
サービスカテゴリー
データエンジニアリング & AI
理想的な用途
データパイプライン、ウェアハウス、MLプラットフォームを構築する企業、または分析とAIのためにデータインフラストラクチャを近代化する必要がある企業。
タイムライン
4 – 12週間
データエンジニアリング & AI/MLにMicrocosmWorksを選ぶ理由
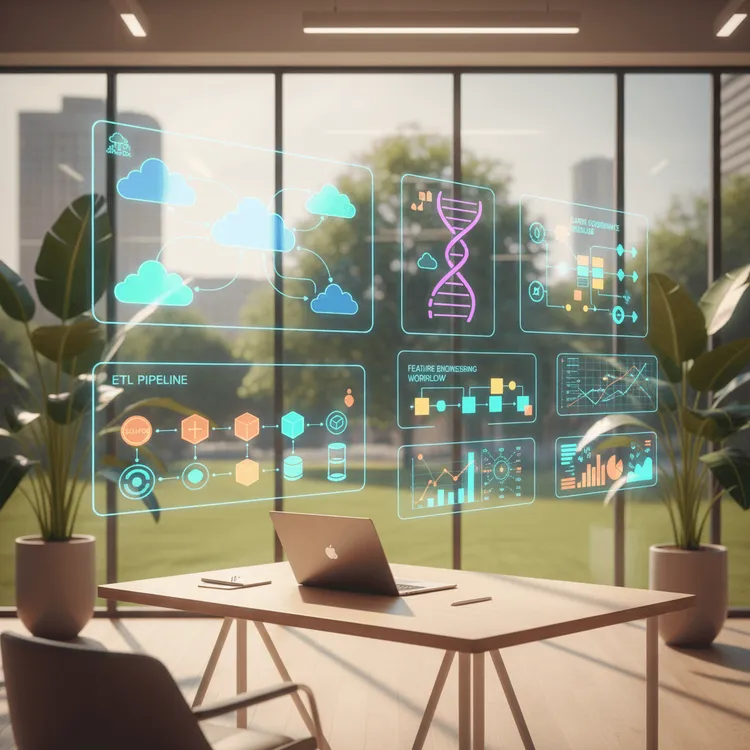
データは、信頼性を持って流れ、適切に変換され、適切なタイミングで正しいシステムに到達することで初めて価値を持ちます。私たちのデータエンジニアリングチームは、データ駆動型の意思決定を可能にし、AWS、GCP、またはAzure上でAIモデルを大規模に展開するための基盤インフラストラクチャ(パイプライン、ウェアハウス、レイクハウス、MLプラットフォーム)を構築します。
データエンジニアリング & AI/MLの能力
- データパイプライン開発 — Airflow、dbt、Spark、またはクラウドネイティブサービスを使用して、あらゆるスケールでデータを処理する信頼性のあるETL/ELTパイプラインを構築します。
- データウェアハウス & レイクハウス — Snowflake、BigQuery、Redshift、またはDatabricks上に現代的なデータプラットフォームを適切なモデリングとガバナンスで設計します。
- リアルタイムストリーミング — Kafka、Kinesis、またはPub/Subを使用してイベント駆動型アーキテクチャを実装し、リアルタイム分析とMLフィーチャーの提供を行います。
- MLプラットフォームセットアップ — 実験追跡、モデルレジストリ、フィーチャーストア、自動トレーニングパイプラインを備えたMLOpsプラットフォームを構築します。
- データ品質 & ガバナンス — 信頼できるコンプライアンスデータのために、データ品質チェック、系統追跡、カタログ化、アクセス制御を実装します。
- AIモデル展開 — サービングインフラストラクチャ、A/Bテスト、モニタリング、自動再トレーニングパイプラインを使用してMLモデルを本番環境に展開します。
- 分析インフラストラクチャ — 適切なセマンティックレイヤーを備えたBIツール、ダッシュボード、セルフサービス分析をビジネスチームのために設定します。
データ & AIテクノロジースタック
私たちは、Apache Spark、Airflow、dbt、Kafka、Flinkを使用してデータプラットフォームを構築し、処理とオーケストレーションを行います。ストレージには、Snowflake、BigQuery、Redshift、Delta Lake、Icebergを使用します。私たちのMLスタックには、MLflow、Kubeflow、SageMaker、Vertex AI、Kubernetes上でGPUサポートを備えたカスタムプラットフォームが含まれています。
対象
このサービスは、データインフラストラクチャを構築または近代化する必要がある企業向けです。初めての分析パイプラインを設定するスタートアップから、MLプラットフォームを構築する企業まで、データサイロ、信頼性の低いパイプライン、MLモデルの展開の難しさに苦労しているチームに、これらの課題を解決するためのエンジニアリングの専門知識を提供します。
私たちのプロセス
1
Discovery
Assess your data sources, current infrastructure, analytics needs, and ML/AI objectives.
2
Architecture
Design the data platform architecture with pipeline topology, storage layers, and ML infrastructure.
3
Implementation
Build data pipelines, deploy warehouses, configure ML platforms, and set up monitoring.
4
Optimization
Tune query performance, optimize pipeline costs, implement data quality checks, and validate ML models.
5
Operations
Hand off with documentation, train data teams, and provide ongoing support for pipeline reliability.
技術スタック
Data Processing
Apache SparkAirflowdbtFlink
Storage
SnowflakeBigQueryRedshiftDelta Lake
ML Platforms
MLflowSageMakerVertex AIKubeflow
Streaming
KafkaKinesisPub/SubSpark Streaming
サービスを提供する業界
E-CommerceFinancial ServicesHealthcareMediaRetailLogisticsTelecomManufacturing
データ & AIプラットフォームを構築する準備はできましたか?
私たちのデータエンジニアが、データを競争優位に変える信頼性のあるパイプラインとMLインフラストラクチャを構築します。
よくある質問
当社は、特徴量エンジニアリング、データラベリングパイプライン、学習データ管理、特徴量ストア、および自動化されたデータ品質検証を含む、MLワークフロー向けのエンドツーエンドのデータパイプラインを構築します。これにより、お客様のモデルにクリーンで信頼性の高いデータが供給されることを保証します。
当社のデータエンジニアリングおよびAI/MLパイプライン開発サービスは、1時間あたり30ドルから50ドルの料金で提供しており、料金はお客様のデータインフラストラクチャとMLワークフローの要件の複雑さに基づいて変動します。
はい、私たちはFeast、Tectonのようなツールや、RedisおよびBigQuery上に構築されたカスタムソリューションを使用してフィーチャーストアを実装します。これにより、お客様のMLチームは、トレーニングと推論の両方で一貫して機能を共有し、発見し、提供できるようになります。
私たちは、モデルのパフォーマンスが低下する前にデータ品質の問題を捕捉するため、Great ExpectationsまたはDeequを使用した自動化されたデータ検証、スキーマ強制、ドリフト検出、および統計的プロファイリングをパイプラインの各段階で実装しています。
はい、MLflowを用いたモデルバージョニング、自動化された再トレーニングトリガー、A/Bテストインフラストラクチャ、および推論負荷に基づいたオートスケーリングによるKubernetes上でのモデルサービングを含む、完全なMLOpsパイプラインを構築します。