ほとんどの検索ボックスは、1つの質問に答えるために存在します。「入力した言葉に何が一致するか?」これは図書館の蔵書目録には適切な質問です。しかし、栄養管理アプリにとっては間違った質問です。
ユーザーがAppetecでレシピページを開いたとき、彼らが入力する単語はリクエストの中で最も重要でない部分です。本当に重要なのは目に見えない情報です。今日の残りカロリー、毎週無意識に作っているもの、ヴィーガンであるかどうか、そして夕食までに予算を使い果たしてしまったかどうか、などです。これらすべてを無視する検索エンジンは、一致するレシピを喜んで返しますが、同時にユーザーがアプリを開いた理由を喜んで台無しにするでしょう。これは、そのギャップを埋めるために構築されたパターンの背後にあるアーキテクチャです。つまり、この人にとって、今、適切な関連性です。
なぜテキストマッチだけでは不十分なのか
このパターンは、同じクエリでもユーザーによって異なる結果を返す必要がある場合に適用されます。つまり、「最適なもの」がユーザーが入力しなかったコンテキストに依存する場合や、所有するカタログがユーザーが期待するカタログよりも小さい場合です。パーソナライズされたレシピ検索は、関連性を1つのシグナルではなく、3つのシグナルの組み合わせとして扱います。
| シグナル | 捕捉するもの |
|---|---|
| Text | ユーザーが入力した内容 — または、食事スキャンモードで、皿の上で検出された内容 |
| Goal fit | そのレシピが、ユーザーが今日、この食事に残したカロリーにどれだけ適合するか |
| Habit | この特定のユーザーが、このレシピを実際にどれくらいの頻度で食べるか |
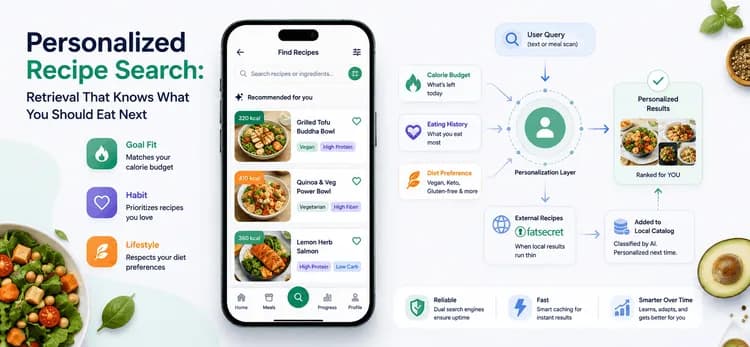
素朴なエンジンは、このテーブルの最初の行しか見ません。このパターンは、これら3つのシグナルすべてを単一のランキングリストに融合させ、ローカルカタログが手薄になった場合は常に外部ソースから補完します。そして、その都度、静かにカタログを成長させます。その結果は、データベースをクエリするというよりは、あなたのキッチンと食生活をすでに知っている友人のように感じられます。
パイプラインの構成
このシステムは、フロントにパーソナライゼーションレイヤー、バックに自己修復型カタログを持つRetrievalパイプラインとして機能します。
2つの検索エンジン、1つの契約。 Elasticsearchがプライマリです。あいまいなタイプミス許容、英語のステミング("grill"で"grilled"を検索)、重み付けされた関連性スコアリングを備えています。もし利用できなくなった場合、同じクエリは同じフィルターとパーソナライゼーションルールに従うMongoDB検索にフォールバックします。検索は障害時には劣化しますが、決して利用不可にはなりません。
ユーザーが感じるが目にすることのないレイヤー。 結果が返される前に、3つの要素がリストを再形成します。カロリー予算は、毎日の目標から記録されたものを差し引いて計算され、残りのウィンドウに合うレシピをブーストします。もしユーザーが目標を超過してしまった場合、リストは静かに低カロリー順に並び替えられ、放縦ではなく回復へと促します。食事履歴は、過去60日間の食事ログを「実際に食べているもの」マップにまとめ、お気に入りをページ1でワンタップでアクセスできるようにします。食事の好み — veg、vegan、non-vegに加えて、keto、gluten-free、high-proteinのような20以上のより詳細なタグ — が、その下のすべてをフィルタリングし、再ランク付けします。
自己成長するカタログ。 ローカルの結果が少なくなる場合、パイプラインは外部ソースのFatSecretからデータを取得し、それらの結果を目に見える継ぎ目なく同じ無限スクロールフィードに組み込みます。その後、LLMを使用して各外部レシピをveg、non-veg、またはveganに分類し、次回正しくパーソナライズできるようにローカルカタログに書き戻します。これは、ローカルと外部の結果が1つのシステムのように感じられる必要がある、私たちが他の場所で適用してきたhybrid retrieval architectureの背後にあるのと同じ考え方です。
3つのキャッシュ、3つの役割。 結合された結果セット、ユーザーごとの習慣マップ、および外部APIレスポンスはそれぞれ独立したライフタイムを持ち、パーソナライズされた複数ソースのクエリでも、単一の単純な検索とほぼ同じ速度で結果が返されます。
言及すべきトレードオフ
これらすべてが無料で実現したわけではなく、そのコストについて正直であることは、このパターンが単に巧妙なだけでなく、信頼できるものである理由の一部です。
関連性は意図的に非中立にされました。 純粋なテキスト関連性ランキングは、ここでは積極的に役に立たない形で「公平」です。結果は意図的に目標への適合と習慣に偏らせています。なぜなら、わずかにテキスト的に完璧でなくても、誰かの予算と好みに合うレシピの方がより良い答えだからです。「なぜこれが1位になったのか?」は、検索エンジンのデフォルトではなく、プロダクトの意思決定になります。そのため、これらの重みは、所有されていないconfigファイルではなく、アプリケーションコードに存在します。
カタログ全体を所有することが目標ではなく、その適切な部分を所有することが目標でした。 考慮された両極端は、完全にキュレーションされたカタログ(高品質、狭い範囲)か、外部APIへの完全なプロキシ(無限の範囲、制御ゼロ、パーソナライゼーションゼロ)でした。このシステムはその中間を取ります。つまり、所有するレシピとユーザーが作成したレシピを優先し、必要に応じて外部から補完し、補完されたものを吸収します。これにより、時間をかけて、ユーザーが実際に検索するものを正確に所有する方向へとトレンドが向かいます。
ピーク効率よりもResilienceが選択されました。 2つの完全な検索エンジンは1つよりも運用コストがかかります。これは、私たちのバックエンドの意思決定のほとんどの背後にあるのと同じresilience-first thinkingです。このコストは意図的に受け入れられました。レシピ検索はコアとなる日常的に使用される機能であり、検索の劣化は軽微な不便ですが、検索が利用できないことはアプリの故障を意味します。
パーソナライゼーションは予測可能性を犠牲にします。 結果は、時間帯、摂取カロリー、履歴によって実際に異なります。同じユーザーであっても、朝食時と夕食時とでは異なります。これは意図されたものですが、テストとサポートの基準を上げます。正しさがユーザーごと、瞬間ごとに定義される場合、「私のスマホでは動く」という言葉の意味は薄れます。
このパターンが適合する場合 — そして適合しない場合
このパターンが適用されるべきでない場所を明確にしておく価値があります。このパターンが複雑さを正当化するのは、ユーザーが入力しなかったコンテキストに基づいて結果がユーザーごとに真に異なるべき場合、所有するカタログがユーザーが期待するよりも小さいが外部から充実させられる場合、機能が頻繁に使用され、最小限のインフラストラクチャよりもgraceful degradationが重要である場合、そして「関連性」がテキスト以外のシグナルを正当に含む場合です。
このパターンは、すべてのユーザーにとって結果が同じである場合(公開ドキュメント検索、SKU検索など)、つまりパーソナライゼーションがコストを増やすだけでメリットがない場合には、間違ったツールです。カタログが小さく、シンプルなフィルタリングを備えた単一のエンジンで十分なほど安定している場合には不要であり、厳密で同一で完全に説明可能なランキングが必須要件となる場所では、不利に働きます。
実際の仕事
ここでのRetrieval品質は、単なるマッチング問題としてではなく、パーソナライゼーション問題として扱われます。ユーザーがヴィーガンであること、すでに予算オーバーであること、そして一ヶ月間同じ5つの夕食を作ってきたことを無視しながら、テキスト的には完璧なレシピ検索は、技術的には機能したが実際には失敗したと言えます。本来の仕事は、クエリに一致するレシピを見つけることではなく、この人が次に作るべきレシピを提示することです。デュアル検索エンジンから、誰かが予算オーバーした際の静かな再ソートに至るまで、このアーキテクチャのすべてのレイヤーは、そのギャップを埋めるために存在します。
ご自身の製品における検索またはRetrievalで同様の「構築 vs 統合」の意思決定を検討されている場合は、ぜひご相談ください。
その他のブログ
1. マイクロサービスによるデジタルヘルスプラットフォームのスケーリング