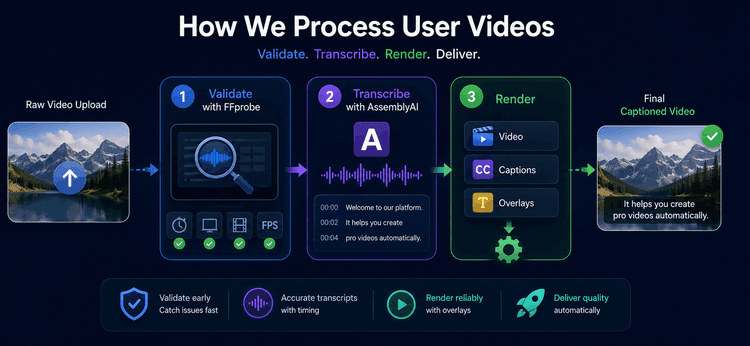
Kapag ang isang user ay nag-upload ng video sa Adstacker, isang bagay ang inaasahan nila: ang kanilang mga clip ay magiging pino na ad variation nang walang nakakalitong paghihintay, sirang export, o mga subtitle na nawawalan ng sync. Sa likod ng simpleng workflow na iyon ay isang sinadyang inihandang AI-powered video pipeline. Bine-validate namin ang bawat asset bago ito pumasok sa isang proyekto, ginagawang frame-accurate subtitle data ang speech, pagkatapos ay nire-render ang magagamit muli na creative components bago buuin ang mga huling variation.
Ganito pinoproseso ng Adstacker ang mga video ng user—mula upload hanggang export—at ito ang dahilan kung bakit ang architecture ay idinisenyo para sa maaasahang creative volume.
Ang hamon: bihira na ang mga video input ay production-ready bilang default
Ang mga video file ay maaaring magmukhang magkatulad sa isang file picker ngunit iba ang pag-uugali sa isang render pipeline. Ang isang clip ay maaaring may hindi inaasahang duration, mababang resolution, isang rotation flag mula sa camera ng telepono, o walang magagamit na video stream. Kung matuklasan namin ang mga problemang iyon pagkatapos magsimulang mag-render ang isang proyekto, mawawalan ng oras ang mga user at nasasayang ang compute.
Ang mga subtitle ay nagdaragdag ng ikalawang hamon. Ang transcript lamang ay hindi sapat para sa isang social ad. Kailangan ng teksto ng word-level timing upang lumabas ito kasama ng nagsasalita, manatiling nababasa, at hindi kailanman mag-overlap sa susunod na linya.
Sa wakas, ang Adstacker ay binuo upang lumikha ng maraming kombinasyon mula sa isang maliit na set ng assets. Ang muling pag-render ng magkakaparehong captioned clips para sa bawat hook, body, CTA, at subtitle-style na kombinasyon ay magiging hindi kinakailangan na mabagal at mahal.
Ang aming solusyon: isang staged pipeline na may malinaw na responsibilidad
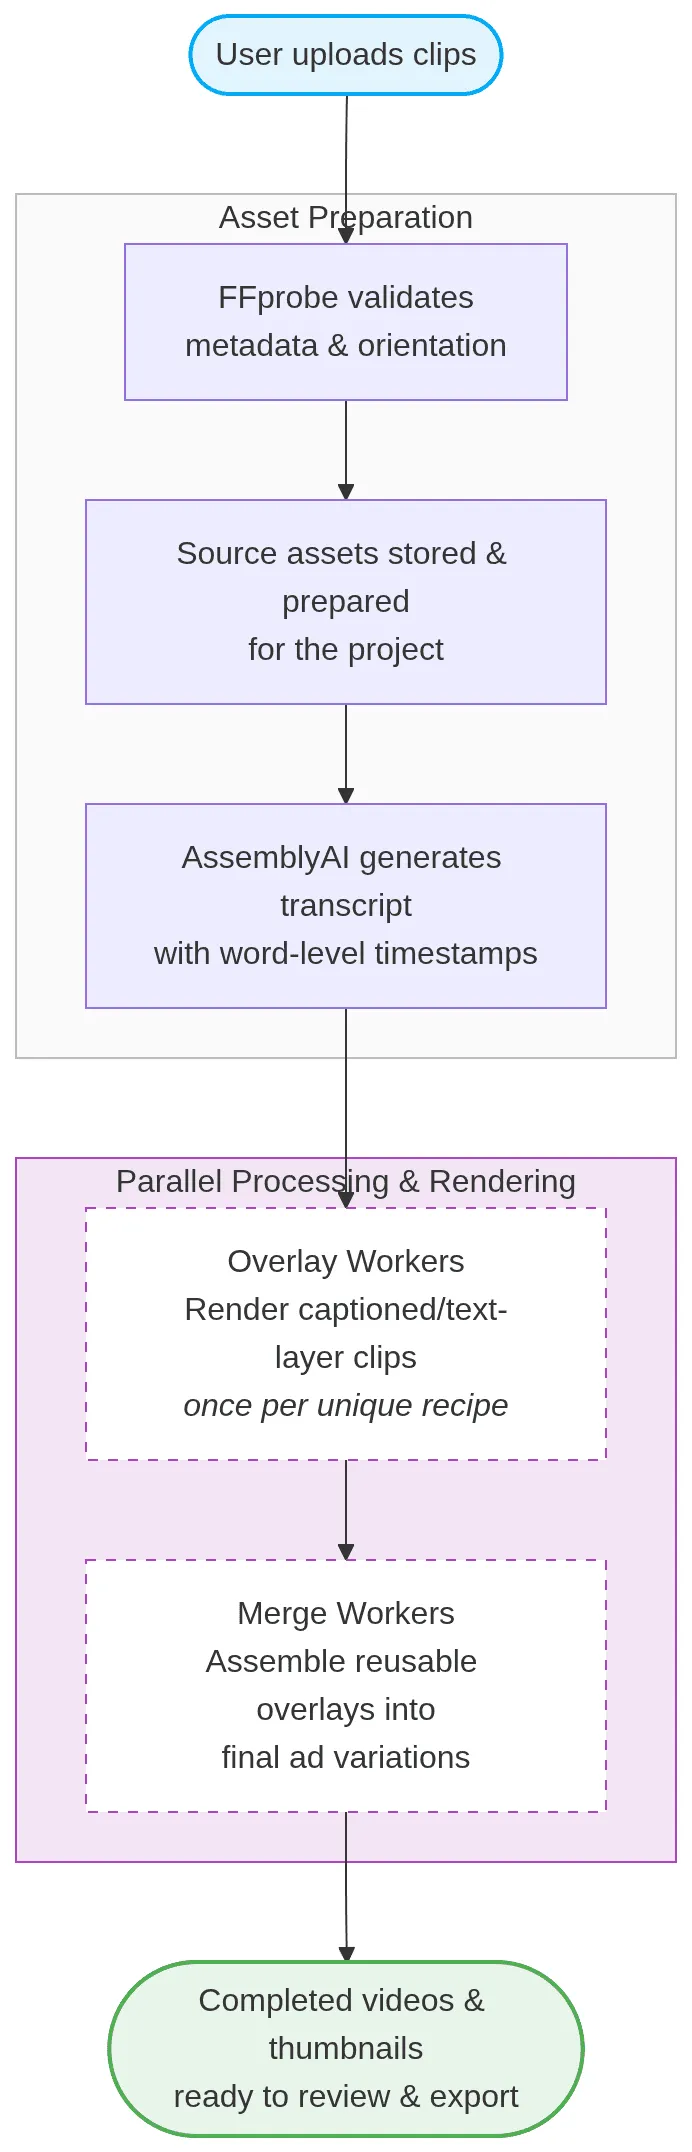
Pinaghihiwalay namin ang validation, transcription, overlay rendering, at final assembly. Ang bawat stage ay gumagawa ng matatag na resulta na maaaring gamitin ng susunod na stage, na nagpapahintulot sa system na subukang muli ang isang nabigong hakbang nang hindi muling sinisimulan ang buong proyekto.
Architecture
1. Hinuhuli ng FFprobe ang masamang inputs bago magsimula ang isang proyekto
Bago i-commit ng Adstacker ang mga na-upload na clip sa isang proyekto, pinapatakbo nito ang FFprobe—isang lightweight media-inspection tool—sa bawat file. Binabasa namin ang mga detalye na mahalaga para sa isang maaasahang output:
- Mayroong aktwal na video stream.
- Ang duration ay nasa loob ng pinapayagang range ng proyekto.
- Ang epektibong resolution ay nakakatugon sa aming minimum quality bar at hindi lumalagpas sa naka-configure na maximum.
- Available ang frame rate para sa mga timing calculation.
- Tama ang display orientation, kabilang ang mga video ng telepono na ang rotation ay nasa metadata sa halip na pixel dimensions.
Ito ay isang fail-fast gate. Kung ang isang asset ay hindi gagawa ng maaasahang ad, makakakuha ang creator ng kapaki-pakinabang na mensahe bago magsimula ang rendering. Pinapayagan din kami nitong pumili ng bounded base resolution para sa proyekto, kaya ang mga downstream worker ay nagpapatakbo sa isang predictable canvas sa halip na hiwalay na hawakan ang bawat raw source size.
2. Ginagawang usable subtitle timing ng AssemblyAI ang speech
Para sa mga proyektong gumagamit ng subtitles, ipinapadala namin ang source audio sa pamamagitan ng AssemblyAI at nakakatanggap ng higit pa sa isang block ng text: nakakatanggap kami ng mga indibidwal na salita na may start at end timestamps. Ang mga timestamps na iyon ang tulay sa pagitan ng sinasalitang wika at visual timing.
Nini-normalize namin ang timing sa seconds, kino-convert ito sa frames sa target frame rate ng proyekto, at pinapangkat ang mga salita sa maikling subtitle chunks. Sinasadya ang pagpapangkat: nagsisimula ang bagong caption pagkatapos ng makabuluhang paghinto o kapag ang kasalukuyang linya ay umabot sa nababasang haba. Ini-clamp din namin ang magkatabing chunks upang isa lamang ang makita sa anumang frame, kahit na nag-o-overlap ang source word timings.
Ang resulta ay subtitle data na maikli, frame-aware, at handa para sa napiling visual style—hindi isang generic na transcript na idinikit sa isang video.
3. I-render ang shared overlays nang isang beses, pagkatapos ay gamiting muli ang mga ito
Ang susi sa creative scale ay ang pag-iwas sa duplicate na trabaho. Ang isang proyekto ng Adstacker ay maaaring ipares ang parehong hook clip sa maraming body clips, CTAs, text layers, at subtitle styles. Nagre-render kami ng isang captioned o text-layered segment nang isang beses para sa bawat natatanging recipe, sa halip na isang beses para sa bawat huling kombinasyon na gumagamit nito. Sinasalamin nito ang automated captioning approach na binuo namin para sa Ssemble, isang short-form video creation platform sa aming portfolio.
Ang isang overlay worker ay nakakatanggap ng inihandang source video, ang target aspect ratio, custom text layers, at ang subtitle chunks. Ni-re-render nito ang visual treatment sa isang consistent canvas at iniimbak ang nakumpletong overlay bilang isang magagamit muli na asset. Ang final merge stage ay pipiliin ang tamang hook, body, at CTA overlays at bubuuin ang tapos na variation.
Ang dibisyong ito ay nagbibigay sa amin ng dalawang praktikal na benepisyo:
- Ang pag-re-reuse ay nagpapababa ng render work kapag maraming kombinasyon ang nagbabahagi ng parehong building blocks.
- Ang independent retries ay nagpapahintulot sa pagkabigo sa isang overlay o isang final merge na ayusin nang hindi itinatapon ang natapos na trabaho.
Halimbawa sa totoong mundo: isang product shoot, dose-dosenang testable ads
Isipin na ang isang brand ng skincare ay nag-a-upload ng tatlong hooks, dalawang product demonstration, at dalawang CTAs. Pumipili rin ito ng dalawang subtitle style. Mabilis na dumarami ang mga creative na posibilidad, ngunit ilang final video ang muling gumagamit ng parehong source segment at caption treatment.
Ini-validate ng Adstacker ang lahat ng pitong clip sa unahan, isinasaalang-alang ang anumang portrait-orientation metadata, at bumubuo ng timed subtitle chunks mula sa bawat spoken segment. Pagkatapos ay lumilikha ito ng bawat kailangan na overlay nang isang beses. Kapag nabuo na ang mga huling kombinasyon, muling ginagamit ng system ang mga inihandang piraso sa halip na paulit-ulit na likhain ang mga ito.
Nakukuha ng brand ang isang consistent set ng ready-to-test ads, habang ginagawa ng pipeline ang pinakamababang kinakailangang trabaho upang likhain ang mga ito.
Binuo para sa maaasahang creative volume
Sa Adstacker, ang video processing ay hindi isang opaque na button na “render”. Ito ay isang sequence ng nakatutok na hakbang: i-validate ang source, intindihin ang speech, i-render ang reusable layers, at buuin ang final creative. Ang istrukturang iyon ay tumutulong sa ami na protektahan ang kalidad sa pag-upload, panatilihing naka-sync ang mga caption, at i-scale ang mga variation nang walang pagtaas ng basura, na tumatakbo sa cloud infrastructure na binuo para sa elastic, containerized workloads.
I-upload ang iyong video assets, piliin ang creative building blocks na gusto mong subukan, at hayaan ang Adstacker na hawakan ang production pipeline sa likod ng mga eksena.
Technology stack: NestJS · FFprobe · AssemblyAI · AWS S3 · AWS ECS Fargate · Remotion · FFmpeg · MongoDB
Magbasa pa mula sa aming team
1. Export Service vs. Video Editor Pipeline