Çoğu arama kutusu tek bir soruyu yanıtlamak için vardır: yazdığım kelimelerle ne eşleşiyor? Bu, bir kütüphane kataloğu için doğru sorudur. Bir beslenme uygulaması için ise yanlış sorudur.
Bir kullanıcı Appetec'teki tarifler sayfasını açtığında, yazdığı kelimeler isteğin en az ilgi çekici kısmıdır. Aslında önemli olan görünmezdir: bugün kalan kalori miktarı, haftalarca düşünmeden pişirdikleri yemekler, vegan olup olmadıkları ve akşam yemeğiyle bütçelerini aşıp aşmadıkları. Tüm bunları göz ardı eden bir search engine, eşleşen tarifleri seve seve döndürür — ve kullanıcının uygulamayı açma nedenini de aynı mutlulukla sabote eder. Bu, bu boşluğu kapatmak için oluşturulmuş bir pattern'in arkasındaki mimaridir: bu kişi için, şu anda doğru olan alaka düzeyi.
Neden Yalnızca Metin Eşleşmesi Yeterli Değil?
Bu pattern, aynı query'nin farklı kullanıcılar için farklı sonuçlar döndürmesi gerektiğinde uygulanır — "en iyi" kullanıcının hiç yazmadığı bir bağlama bağlı olduğunda ve sahip olduğunuz katalog, kullanıcılarınızın beklediği katalogdan daha küçük olduğunda. Kişiselleştirilmiş tarif araması, alaka düzeyini tek bir sinyal yerine üç sinyalin birleşimi olarak ele alır:
| Sinyal | Neyi Yakalar |
|---|---|
| Metin | Kullanıcının yazdıkları — veya, yemek tarama modunda, tabağında algılananlar |
| Hedef Uyumu | Bir tarifin, kullanıcının bu öğün için bugün kalan kalorilerine ne kadar iyi uyduğu |
| Alışkanlık | Bu belirli kullanıcının bu tarifi gerçekte ne sıklıkla yediği |
Basit bir engine, o tablonun yalnızca ilk satırını görür. Bu pattern, her üçünü tek bir sıralı listeye kaynaştırır, ardından yerel katalog azaldığında harici bir kaynaktan geri doldurma yapar — her yaptığında bu kataloğu sessizce büyütür. Sonuç, bir database'i sorgulamaktan çok, mutfağınızı ve diyetinizi zaten bilen bir arkadaş gibi hissettirir.
Pipeline Nasıl Bir Araya Getirilir
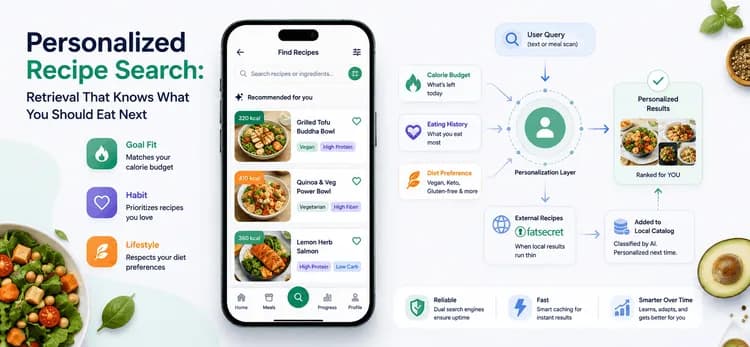
Sistem, önünde bir personalization layer ve arkasında kendini onaran bir katalog ile bir retrieval pipeline olarak çalışır.
İki search engine, tek bir sözleşme. Elasticsearch birincildir: bulanık yazım hatası toleransı, İngilizce stemming ("grill", "grilled"ı bulur), ağırlıklı alaka düzeyi puanlaması. Eğer hiç kullanılamaz hale gelirse, aynı query, aynı filter'ları ve personalization kurallarını dikkate alan bir MongoDB aramasına düşer. Search, arıza durumunda bozulur; asla kaybolmaz.
Kullanıcıların hissettiği ama asla görmediği katman. Sonuçlar dönmeden önce, üç şey listeyi yeniden şekillendirir. Kalori bütçesi, günlük hedeften kaydedilenler çıkarılarak hesaplanır ve kalan boşluğa uyan tarifleri artırır — ve eğer kullanıcı hedefini aşmışsa, liste sessizce en düşük kalorili olanlardan başlayarak yeniden sıralanır, hoşgörü yerine iyileşmeye yönlendirir. Yeme geçmişi, son 60 günlük öğün kayıtlarını "gerçekten ne yediğiniz" haritasına dönüştürür, favorileri ilk sayfada tek bir dokunuşla ulaşılabilir kılar. Diyet tercihi — veg, vegan, non-veg, ayrıca keto, gluten-free ve high-protein gibi iki düzine daha ince tag — altındaki her şeyi filter'lar ve yeniden sıralar.
Kendi kendine büyüyen bir katalog. Yerel sonuçlar azaldığında, pipeline harici bir kaynak olan FatSecret'e sayfalar, bu sonuçları görünür bir dikiş olmadan aynı infinite-scroll feed'ine diker. Ardından, bir LLM kullanarak her birini veg, non-veg veya vegan olarak sınıflandırarak bu harici tarifleri yerel kataloğa geri yazar, böylece bir dahaki sefere doğru bir şekilde personalizable olur — yerel ve harici sonuçların tek bir sistem gibi hissetmesi gereken, başka yerlerde uyguladığımız bir hibrit retrieval mimarisinin arkasındaki aynı içgüdü.
Üç cache, üç görev. Birleştirilmiş sonuç setleri, kullanıcı başına alışkanlık haritası ve external-API yanıtları, her biri kendi bağımsız ömrünü taşır, böylece kişiselleştirilmiş, çok kaynaklı bir query yine de tek bir basit lookup hızında geri döner.
Dikkate Değer Ödünleşimler
Bunların hiçbiri bedelsiz gelmedi ve maliyet hakkında dürüst olmak, pattern'i sadece akıllıca değil, aynı zamanda güvenilir kılan şeyin bir parçasıdır.
Alaka düzeyi kasıtlı olarak taraflı hale getirildi. Saf bir metin-alaka düzeyi sıralaması, burada aktif olarak faydasız olan bir şekilde "adil"dir. Sonuçlar, bilerek hedef uyumu ve alışkanlığa doğru ön yargılıdır, çünkü birisinin bütçesine ve zevkine uyan, metinsel olarak biraz daha az mükemmel bir tarif daha iyi cevaptır. "Bu neden birinci sırada yer aldı?" bir search-engine varsayılanı değil, bir ürün kararı haline gelir — bu yüzden bu ağırlıklar, sahip olunmayan bir config file'da değil, application code'unda bulunur.
Tüm kataloğa sahip olmak amaç değildi — doğru kısmına sahip olmak amaçtı. Ele alınan uç noktalar, tamamen derlenmiş bir katalog (yüksek kalite, dar kapsam) veya harici bir API'ye tam bir proxy (sınırsız kapsam, sıfır kontrol, sıfır personalization) idi. Sistem farkı böler: sahip olunan ve kullanıcı tarafından oluşturulan tariflerle başla, gerektiğinde dışarıdan geri doldur ve geri doldurulanları em — zamanla, kullanıcıların gerçekten aradıklarına tam olarak sahip olmaya yönelerek.
En yüksek verimlilik yerine esneklik tercih edildi. İki tam search engine'i işletmek, bir taneden daha pahalıdır — backend kararlarımızın çoğunun arkasındaki aynı esneklik-öncelikli düşünme. Bu maliyet bilerek kabul edildi: tarif araması temel, günlük kullanılan bir işlevsellik olup, bozulmuş arama küçük bir sıkıntı iken, eksik arama bozuk bir uygulama demektir.
Kişiselleştirme, öngörülebilirlik maliyeti yaratır. Sonuçlar, günün saatine, tüketilen kalorilere ve geçmişe göre gerçekten farklılık gösterir — aynı kullanıcı için kahvaltı ve akşam yemeği arasında bile. Bu kasıtlıdır, ancak test ve destek için çıtayı yükseltir: doğruluk kullanıcı başına, an başına tanımlandığında "telefonumda çalışıyor" çok anlam ifade etmez.
Bu Pattern Ne Zaman Uygun — ve Ne Zaman Değil
Bu pattern'in ulaşılmaması gereken yerler hakkında net olmakta fayda var. Sonuçların, kullanıcıların hiç yazmadığı bir bağlama göre kullanıcı başına gerçekten farklılık göstermesi gerektiğinde, sahip olunan katalog kullanıcıların beklediğinden daha küçük ancak dışarıdan zenginleştirilebildiğinde, özelliğin yeterince sık kullanıldığı ve zarif bozulmanın minimum altyapıdan daha önemli olduğu durumlarda ve "alaka düzeyi" meşru bir şekilde metnin ötesinde sinyaller içerdiğinde karmaşıklığını hak eder.
Sonuçların her kullanıcı için aynı olduğu durumlarda yanlış bir araçtır — halka açık bir docs search, bir SKU lookup gibi — burada personalization hiçbir getiri sağlamadan maliyet ekler. Katalog, basit filtering'e sahip tek bir engine'in yeterli olacağı kadar küçük ve kararlı olduğunda gereksizdir ve katı, aynı, tamamen açıklanabilir sıralamanın zorunlu bir gereklilik olduğu her yerde size karşı çalışır.
Gerçek İş
Burada retrieval kalitesi, yalnızca bir eşleştirme problemi değil, bir personalization problemi olarak ele alınır. Kullanıcının vegan olduğunu, zaten bütçesini aştığını ve ay boyunca aynı beş akşam yemeğini pişirdiğini göz ardı ederken metinsel olarak mükemmel olan bir tarif araması teknik olarak çalışmış ama pratik olarak başarısız olmuştur. İş asla query ile eşleşen tarifleri bulmak değildi — bu kişinin bir sonraki pişirmesi gereken tarifi ortaya çıkarmaktır. Bu mimarinin her katmanı, çift search engine'lerden birisi bütçesini aştığında sessizce yeniden sıralamaya kadar, bu boşluğu kapatmak için mevcuttur.
Kendi ürününüzde search veya retrieval için benzer bir oluşturma-karıştırma kararı tartıyorsanız, konuşmaktan memnuniyet duyarız.
Diğer Bloglar
1. Microservices ile Dijital Bir Sağlık Platformunu Ölçeklendirme
2. Apple Health ve Health Connect Senkronizasyonu
3. Farklı Video Çözünürlükleri için Kanal Logosu Optimizasyonu