عندما يقوم المستخدم بتحميل فيديو إلى Adstacker، يتوقع شيئًا واحدًا: يجب أن تتحول مقاطع الفيديو الخاصة بهم إلى إصدارات إعلانية مصقولة دون انتظار محير، أو تصدير معطل، أو ترجمات تخرج عن التزامن. وراء هذا التدفق البسيط للعمل توجد خط أنابيب فيديو مدعوم بالذكاء الاصطناعي. نقوم بالتحقق من كل عنصر قبل دخوله إلى المشروع، نحول الكلام إلى بيانات ترجمات دقيقة الإطار، ثم نقوم بتصميم مكونات إبداعية قابلة لإعادة الاستخدام قبل تجميع الإصدارات النهائية.
هذا هو كيفية معالجة Adstacker لمقاطع الفيديو الخاصة بالمستخدمين - من التحميل إلى التصدير - ولماذا تم تصميم البنية لتحقيق حجم إبداعي موثوق.
التحدي: مدخلات الفيديو نادرًا ما تكون جاهزة للإنتاج افتراضيًا
يمكن أن تبدو ملفات الفيديو متشابهة في منتقي الملفات بينما تتصرف بشكل مختلف تمامًا في خط أنابيب التصميم. قد يكون للمقطع مدة غير متوقعة، دقة منخفضة، علم دوران من كاميرا الهاتف، أو لا يحتوي على تيار فيديو قابل للاستخدام على الإطلاق. إذا اكتشفنا هذه المشاكل بعد بدء مشروع التصميم، فإن المستخدمين يفقدون الوقت ويتم إهدار الحوسبة.
تضيف الترجمات تحديًا ثانيًا. النص وحده لا يكفي لإعلان اجتماعي. يحتاج النص إلى توقيت على مستوى الكلمة حتى يظهر مع المتحدث، يبقى مقروءًا، ولا يتداخل أبدًا مع السطر التالي.
أخيرًا، تم بناء Adstacker لإنشاء العديد من التركيبات من مجموعة صغيرة من الأصول. إعادة تصميم المقاطع المترجمة المتطابقة لكل خطاف، جسم، CTA، وتركيب ترجمات سيكون بطيئًا ومكلفًا بشكل غير ضروري.
حلنا: خط أنابيب مرحلي مع مسؤوليات واضحة
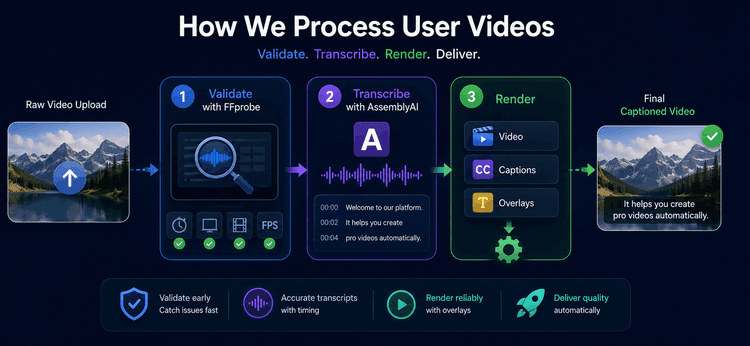
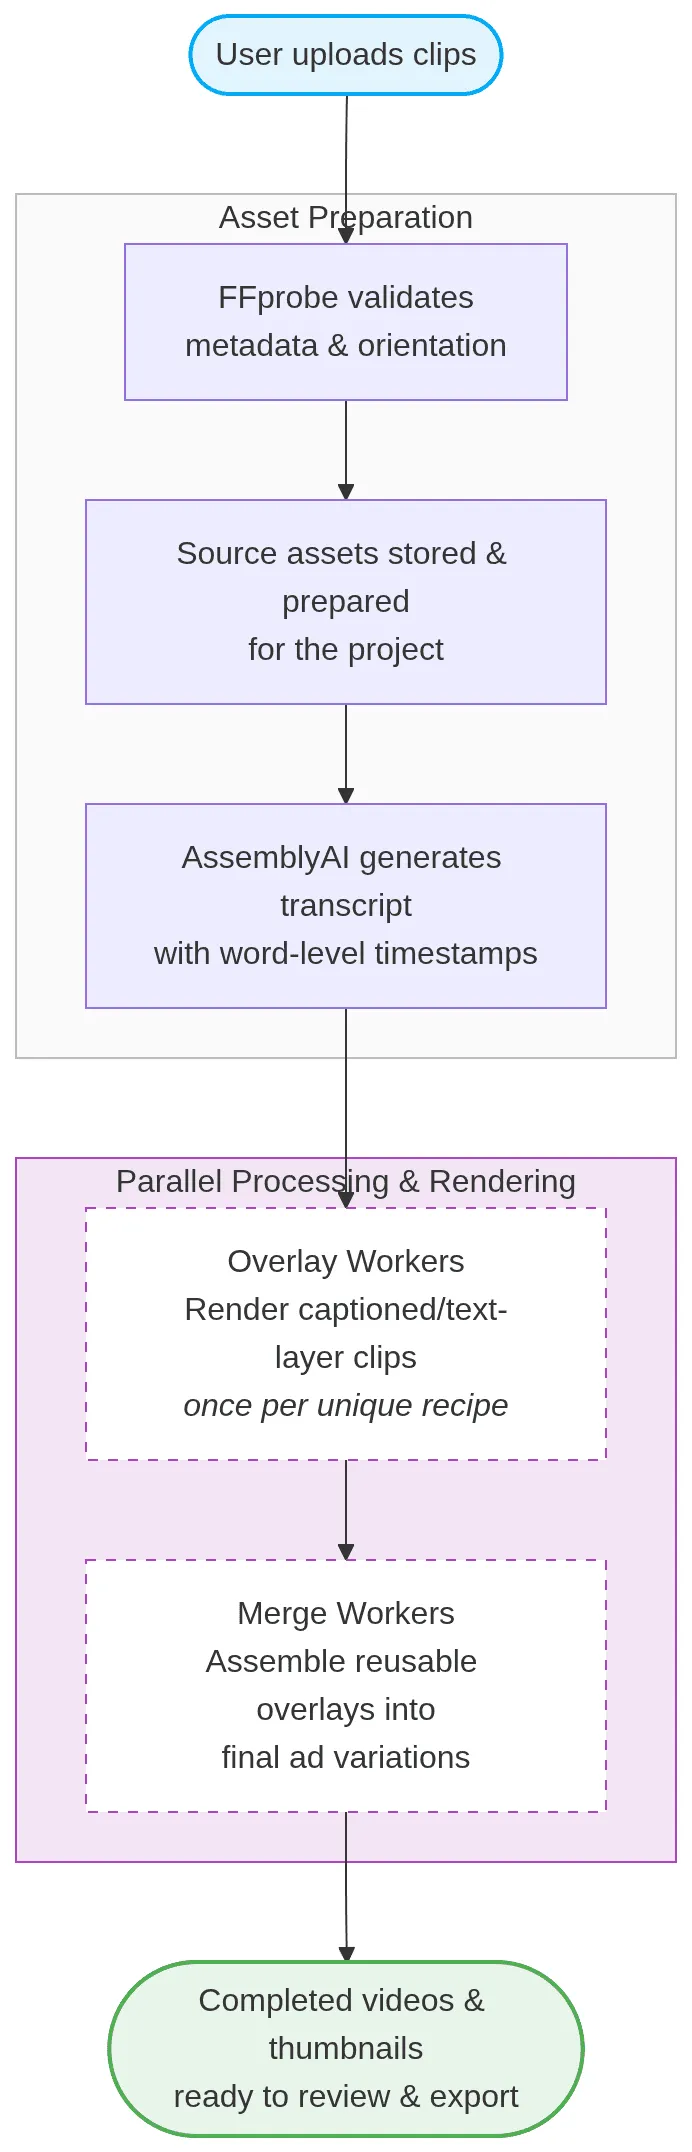
نقوم بفصل التحقق، النسخ، تصميم التراكب، والتجميع النهائي. ينتج كل مرحلة نتيجة متينة يمكن للمرحلة التالية استخدامها، مما يسمح للنظام بإعادة محاولة خطوة فاشلة دون إعادة بدء المشروع بالكامل.
البنية
1. FFprobe يلتقط المدخلات السيئة قبل بدء المشروع
قبل أن يلتزم Adstacker بالمقاطع المحملة إلى مشروع، يقوم بتشغيل FFprobe - أداة فحص وسائط خفيفة الوزن - على كل ملف. نقرأ التفاصيل التي تهم للحصول على نتيجة موثوقة:
- وجود تيار فيديو حقيقي.
- المدة داخل النطاق المسموح به للمشروع.
- الدقة الفعالة تفي بمعيار الجودة الأدنى لدينا ولا تتجاوز الحد الأقصى المكون.
- معدل الإطارات متاح لحساب التوقيت.
- اتجاه العرض صحيح، بما في ذلك مقاطع الفيديو الهاتفية التي يعيش دورانها في البيانات الوصفية بدلاً من أبعاد البكسل.
هذا هو بوابة الفشل السريع. إذا كان الأصل لن ينتج إعلانًا موثوقًا، يحصل المنشئ على رسالة مفيدة قبل بدء التصميم. كما يسمح لنا باختيار دقة أساسية محددة للمشروع، بحيث يعمل العمال في المراحل اللاحقة على لوحة قماشية متوقعة بدلاً من التعامل مع كل حجم مصدر خام بشكل مستقل.
2. AssemblyAI يحول الكلام إلى توقيت ترجمات قابل للاستخدام
بالنسبة للمشاريع التي تستخدم الترجمات، نرسل الصوت المصدر عبر AssemblyAI ونتلقى أكثر من مجرد كتلة من النص: نحصل على كلمات فردية مع توقيتات بدء وانتهاء. تلك التوقيتات هي الجسر بين اللغة المنطوقة والتوقيت البصري.
نقوم بتطبيع التوقيت إلى ثوانٍ، نحوله إلى إطارات بمعدل الإطارات المستهدف للمشروع، ونجمع الكلمات في قطع ترجمات قصيرة. التجميع متعمد: يبدأ تعليق جديد بعد توقف ذو معنى أو بمجرد أن يصل السطر الحالي إلى طول قابل للقراءة. نقوم أيضًا بتثبيت القطع المجاورة بحيث يكون واحد فقط مرئيًا في أي إطار، حتى عندما تتداخل توقيتات الكلمات المصدر.
النتيجة هي بيانات ترجمات مختصرة، مدركة للإطار، وجاهزة لأسلوب بصري مختار - ليست نصًا عامًا ملصقًا على الفيديو.
3. تصميم التراكبات المشتركة مرة واحدة، ثم إعادة استخدامها
المفتاح للتوسع الإبداعي هو تجنب العمل المكرر. قد يقرن مشروع Adstacker نفس مقطع الخطاف مع العديد من مقاطع الجسم، CTAs، طبقات النص، وأنماط الترجمات. نقوم بتصميم مقطع مترجم أو بطبقات نصية مرة واحدة لكل وصفة فريدة، بدلاً من مرة لكل تركيبة نهائية تصادف استخدامها. هذا يعكس نهج الترجمة التلقائية الذي بنيناه لـ Ssemble، منصة لإنشاء الفيديوهات القصيرة في محفظتنا.
يتلقى عامل التراكب الفيديو المصدر المحضر، نسبة العرض إلى الارتفاع المستهدفة، طبقات النص المخصصة، وقطع الترجمات. يقوم بتصميم المعالجة البصرية على لوحة قماشية متسقة ويخزن التراكب المكتمل كأصل قابل لإعادة الاستخدام. ثم تختار مرحلة الدمج النهائية التراكبات الصحيحة للخطاف، الجسم، وCTA وتجمع النسخة النهائية.
هذا التقسيم يمنحنا فائدتين عمليتين:
- إعادة الاستخدام تخفض عمل التصميم عندما تشترك العديد من التركيبات في نفس اللبنات الأساسية.
- إعادة المحاولات المستقلة تسمح بإصلاح فشل في تراكب واحد أو دمج نهائي واحد دون التخلص من العمل المكتمل.
مثال في العالم الحقيقي: جلسة تصوير منتج واحدة، عشرات الإعلانات القابلة للاختبار
تخيل أن علامة تجارية للعناية بالبشرة تقوم بتحميل ثلاثة خطافات، عرضين للمنتج، واثنين من CTAs. كما تختار نمطي ترجمات. تتضاعف الإمكانيات الإبداعية بسرعة، لكن العديد من مقاطع الفيديو النهائية تعيد استخدام نفس المقطع المصدر ومعالجة الترجمات.
يقوم Adstacker بالتحقق من جميع المقاطع السبعة مقدمًا، يأخذ في الاعتبار أي بيانات وصفية للاتجاه الرأسي، ويبني قطع ترجمات موقوتة من كل مقطع منطوق. ثم يقوم بإنشاء كل تراكب مطلوب مرة واحدة. عند تجميع التركيبات النهائية، يعيد النظام استخدام تلك القطع المحضرة بدلاً من إعادة إنشائها بشكل متكرر.
تحصل العلامة التجارية على مجموعة متسقة من الإعلانات الجاهزة للاختبار، بينما يقوم خط الأنابيب بالحد الأدنى من العمل اللازم لإنشائها.
مصمم لحجم إبداعي موثوق
في Adstacker، معالجة الفيديو ليست مجرد زر "تصميم" غامض. إنها سلسلة من الخطوات المركزة: التحقق من المصدر، فهم الكلام، تصميم الطبقات القابلة لإعادة الاستخدام، وتجميع الإبداع النهائي. تساعدنا هذه البنية في حماية الجودة عند التحميل، إبقاء الترجمات متزامنة، وتوسيع الإصدارات دون توسيع الهدر، تعمل على بنية تحتية سحابية مصممة لأعمال مرنة ومعبأة في حاويات.
قم بتحميل أصول الفيديو الخاصة بك، اختر اللبنات الإبداعية التي تريد اختبارها، ودع Adstacker يتولى خط الإنتاج خلف الكواليس.
التقنية المستخدمة: NestJS · FFprobe · AssemblyAI · AWS S3 · AWS ECS Fargate · Remotion · FFmpeg · MongoDB
اقرأ المزيد من فريقنا