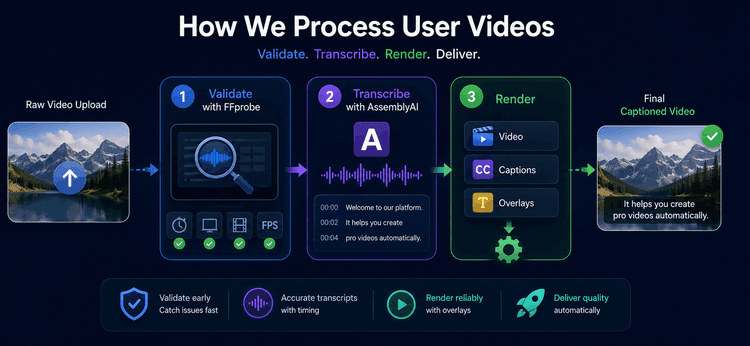
כשמשתמש מעלה סרטון ל-Adstacker, הוא מצפה לדבר אחד: שהקליפים שלו יהפכו לווריאציות מודעה מלוטשות ללא המתנה מבלבלת, ייצוא שבור, או כתוביות שיוצאות מסינכרון. מאחורי זרימת עבודה פשוטה זו עומד AI-powered video pipeline מתוכנן בקפידה. אנו מאמתים כל asset לפני שהוא נכנס לפרויקט, הופכים דיבור לנתוני כתוביות מדויקים לפי פריים, ואז מבצעים render לרכיבים קריאייטיביים לשימוש חוזר לפני הרכבת וריאציות סופיות.
כך Adstacker מעבד סרטוני משתמשים – מהעלאה ועד ייצוא – ומדוע הארכיטקטורה תוכננה עבור נפח יצירתי אמין.
האתגר: קלטי וידאו לעיתים רחוקות מוכנים לייצור כברירת מחדל
קבצי וידאו יכולים להיראות דומים ב-file picker בעודם מתנהגים באופן שונה מאוד ב-render pipeline. לקליפ עשויה להיות משך זמן בלתי צפוי, רזולוציה נמוכה, rotation flag ממצלמת טלפון, או בכלל לא video stream שמיש. אם אנו מגלים בעיות אלו לאחר שהפרויקט החל ב-rendering, משתמשים מאבדים זמן ומשאבי compute מבוזבזים.
כתוביות מוסיפות אתגר שני. transcript בלבד אינו מספיק למודעת social. טקסט זקוק ל-word-level timing כדי שיופיע עם הדובר, יישאר קריא, ולעולם לא יחפוף את השורה הבאה.
לבסוף, Adstacker נבנה ליצירת שילובים רבים מתוך סט קטן של assets. Re-rendering של קליפים מתורגמים זהים לכל hook, body, CTA, ושילוב subtitle-style יהיה איטי ויקר ללא צורך.
הפתרון שלנו: pipeline מדורג עם אחריות ברורה
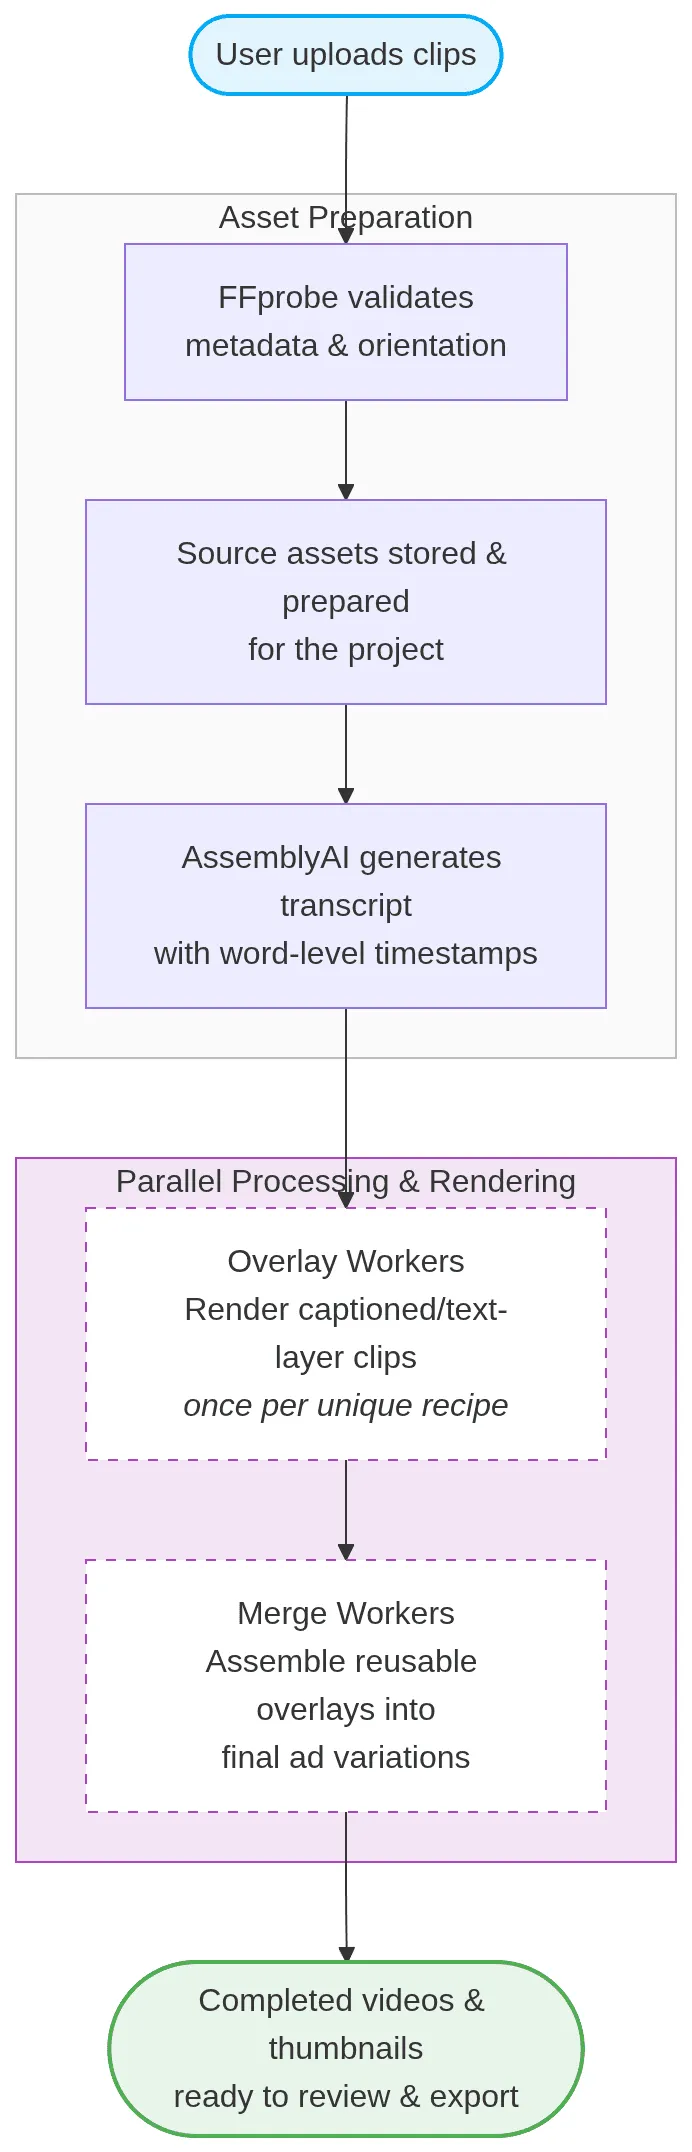
אנו מפרידים validation, transcription, overlay rendering, ו-final assembly. כל שלב מפיק תוצאה עמידה שהשלב הבא יכול להשתמש בה, מה שמאפשר למערכת לנסות שוב צעד שנכשל מבלי להפעיל מחדש את הפרויקט כולו.
ארכיטקטורה
1. FFprobe מזהה קלטים שגויים לפני שהפרויקט מתחיל
לפני ש-Adstacker מקצה קליפים שהועלו לפרויקט, הוא מריץ את FFprobe – כלי קל משקל לבדיקת מדיה – על כל קובץ. אנו קוראים את הפרטים החשובים לתפוקה אמינה:
- קיים video stream אמיתי.
- משך הזמן נמצא בטווח המותר של הפרויקט.
- רזולוציה אפקטיבית עומדת בסף האיכות המינימלי שלנו ואינה חורגת מהמקסימום שהוגדר.
- Frame rate זמין לחישובי תיזמון.
- כיוון התצוגה נכון, כולל סרטוני טלפון שהסיבוב שלהם נמצא ב-metadata ולא במימדי הפיקסלים.
זהו fail-fast gate. אם asset לא יפיק מודעה אמינה, היוצר מקבל הודעה שימושית לפני שמתחיל ה-rendering. זה גם מאפשר לנו לבחור bounded base resolution לפרויקט, כך ש-downstream workers פועלים על קנבס צפוי במקום לטפל בכל גודל מקור גולמי באופן עצמאי.
2. AssemblyAI הופך דיבור לתיזמון כתוביות שמיש
עבור פרויקטים המשתמשים בכתוביות, אנו שולחים את אודיו המקור דרך AssemblyAI ומקבלים יותר מבלוק טקסט: אנו מקבלים מילים בודדות עם timestamps של התחלה וסיום. חותמות זמן אלו הן הגשר בין שפה מדוברת לתיזמון ויזואלי.
אנו מנרמלים את התיזמון לשניות, ממירים אותו לפריימים ב-frame rate היעד של הפרויקט, ומקבצים מילים ל-subtitle chunks קצרים. הקיבוץ מכוון: caption חדש מתחיל לאחר הפסקה משמעותית או כאשר השורה הנוכחית מגיעה לאורך קריא. אנו גם מבצעים clamp לגושים סמוכים כך שרק אחד יהיה גלוי בכל פריים, גם כאשר תיזמוני מילים מהמקור חופפים.
התוצאה היא נתוני כתוביות תמציתיים, מודעים לפריימים, ומוכנים לסגנון ויזואלי נבחר – לא transcript גנרי שהודבק על סרטון.
3. בצעו render לשכבות-על (overlays) משותפות פעם אחת, ואז השתמשו בהן שוב
המפתח לקנה מידה יצירתי הוא הימנעות מעבודה כפולה. פרויקט Adstacker עשוי לשלב את אותו hook clip עם קליפים רבים של body, CTAs, שכבות טקסט, ו-subtitle styles. אנו מבצעים render לקטע מתורגם או בעל שכבת טקסט פעם אחת עבור כל recipe ייחודי, במקום פעם אחת עבור כל שילוב סופי המשתמש בו. גישה זו משקפת את גישת הכתוביות האוטומטיות שבנינו עבור Ssemble, פלטפורמת יצירת וידאו קצר בפורטפוליו שלנו.
overlay worker מקבל את וידאו המקור המוכן, יחס הגובה-רוחב (aspect ratio) הרצוי, שכבות טקסט מותאמות אישית, ו-subtitle chunks. הוא מבצע render לעיבוד הוויזואלי על קנבס עקבי ושומר את ה-overlay שהושלמה כ-asset לשימוש חוזר. שלב ה-merge הסופי בוחר את ה-overlays הנכונים של hook, body ו-CTA ומרכיב את הווריאציה המוגמרת.
חלוקה זו מעניקה לנו שני יתרונות מעשיים:
- שימוש חוזר מפחית עבודת render כאשר שילובים רבים חולקים את אותם אבני בניין.
- ניסיונות חוזרים עצמאיים מאפשרים לתקן כשל ב-overlay אחד או ב-final merge אחד מבלי לזרוק עבודה שהושלמה.
דוגמה מהעולם האמיתי: צילום מוצר אחד, עשרות מודעות שניתן לבדוק
דמיינו מותג טיפוח עור המעלה שלושה hooks, שתי הדגמות מוצר ושני CTAs. הוא גם בוחר שני subtitle styles. האפשרויות היצירתיות מתרבות במהירות, אך מספר סרטונים סופיים עושים שימוש חוזר באותו source segment ו-caption treatment.
Adstacker מאמת את כל שבעת הקליפים מראש, מתחשב בכל metadata של כיוון דיוקן, ובונה subtitle chunks מתוזמנים מכל segment מדובר. לאחר מכן הוא יוצר כל overlay נחוצה פעם אחת. כאשר השילובים הסופיים מורכבים, המערכת משתמשת מחדש בחלקים שהוכנו במקום ליצור אותם שוב ושוב.
המותג מקבל סט עקבי של מודעות מוכנות לבדיקה, בעוד ה-pipeline מבצע את העבודה המינימלית הנדרשת כדי ליצור אותן.
נבנה עבור נפח יצירתי אמין
ב-Adstacker, עיבוד וידאו אינו כפתור “render” אחד אטום. זוהי רצף של שלבים ממוקדים: אימות המקור, הבנת הדיבור, render של שכבות לשימוש חוזר, והרכבת הקריאייטיב הסופי. מבנה זה עוזר לנו להגן על האיכות בעת ההעלאה, לשמור על סינכרון הכתוביות, ולהרחיב וריאציות מבלי להרחיב בזבוז, כשהוא פועל על cloud infrastructure שנבנה עבור elastic, containerized workloads.
העלו את video assets שלכם, בחרו את אבני הבניין הקריאייטיביות שברצונכם לבדוק, ותנו ל-Adstacker לטפל ב-production pipeline מאחורי הקלעים.
Technology stack: NestJS · FFprobe · AssemblyAI · AWS S3 · AWS ECS Fargate · Remotion · FFmpeg · MongoDB
קראו עוד מהצוות שלנו
1. Export Service vs. Video Editor Pipeline