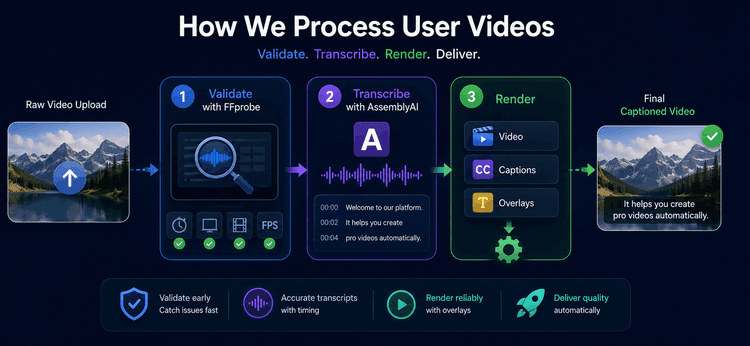
사용자가 Adstacker에 비디오를 업로드할 때 기대하는 것은 단 하나입니다. 바로 혼란스러운 기다림, 깨진 내보내기, 또는 싱크가 맞지 않는 자막 없이 깔끔하게 다듬어진 광고 영상으로 변환되는 것입니다. 이 간단한 워크플로 뒤에는 의도적으로 단계화된 AI 기반 비디오 Pipeline이 있습니다. 우리는 모든 에셋이 프로젝트에 들어가기 전에 유효성을 검사하고, 음성을 프레임 단위로 정확한 자막 데이터로 변환한 다음, 최종 영상들을 조합하기 전에 재사용 가능한 크리에이티브 구성 요소를 렌더링합니다.
이것이 Adstacker가 사용자 비디오를 업로드부터 내보내기까지 처리하는 방식이며, 아키텍처가 안정적인 크리에이티브 볼륨을 위해 설계된 이유입니다.
과제: 비디오 입력은 기본적으로 프로덕션 준비가 거의 되어 있지 않습니다.
비디오 파일은 파일 선택기에서 비슷하게 보일 수 있지만, 렌더 Pipeline에서는 매우 다르게 작동할 수 있습니다. 클립은 예상치 못한 길이, 낮은 해상도, 휴대폰 카메라의 회전 플래그, 또는 아예 사용 가능한 비디오 스트림이 없을 수 있습니다. 프로젝트 렌더링이 시작된 후에 이러한 문제를 발견하면, 사용자들은 시간을 낭비하고 컴퓨팅 자원이 낭비됩니다.
자막은 두 번째 과제를 추가합니다. 단순한 스크립트만으로는 소셜 광고에 충분하지 않습니다. 텍스트는 화자와 함께 나타나고, 읽기 쉬우며, 다음 줄과 겹치지 않도록 단어 단위의 타이밍이 필요합니다.
마지막으로, Adstacker는 소수의 에셋으로 다양한 조합을 생성하도록 구축되었습니다. 모든 Hook, Body, CTA, 그리고 자막 스타일 조합마다 동일한 캡션이 달린 클립을 다시 렌더링하는 것은 불필요하게 느리고 비용이 많이 들 것입니다.
우리의 솔루션: 명확한 책임 분담이 있는 단계별 Pipeline
우리는 유효성 검사, 전사(transcription), 오버레이 Rendering 및 최종 조립을 분리합니다. 각 단계는 다음 단계가 사용할 수 있는 영구적인 결과를 생성하여, 전체 프로젝트를 다시 시작하지 않고도 실패한 단계를 재시도할 수 있도록 합니다.
아키텍처
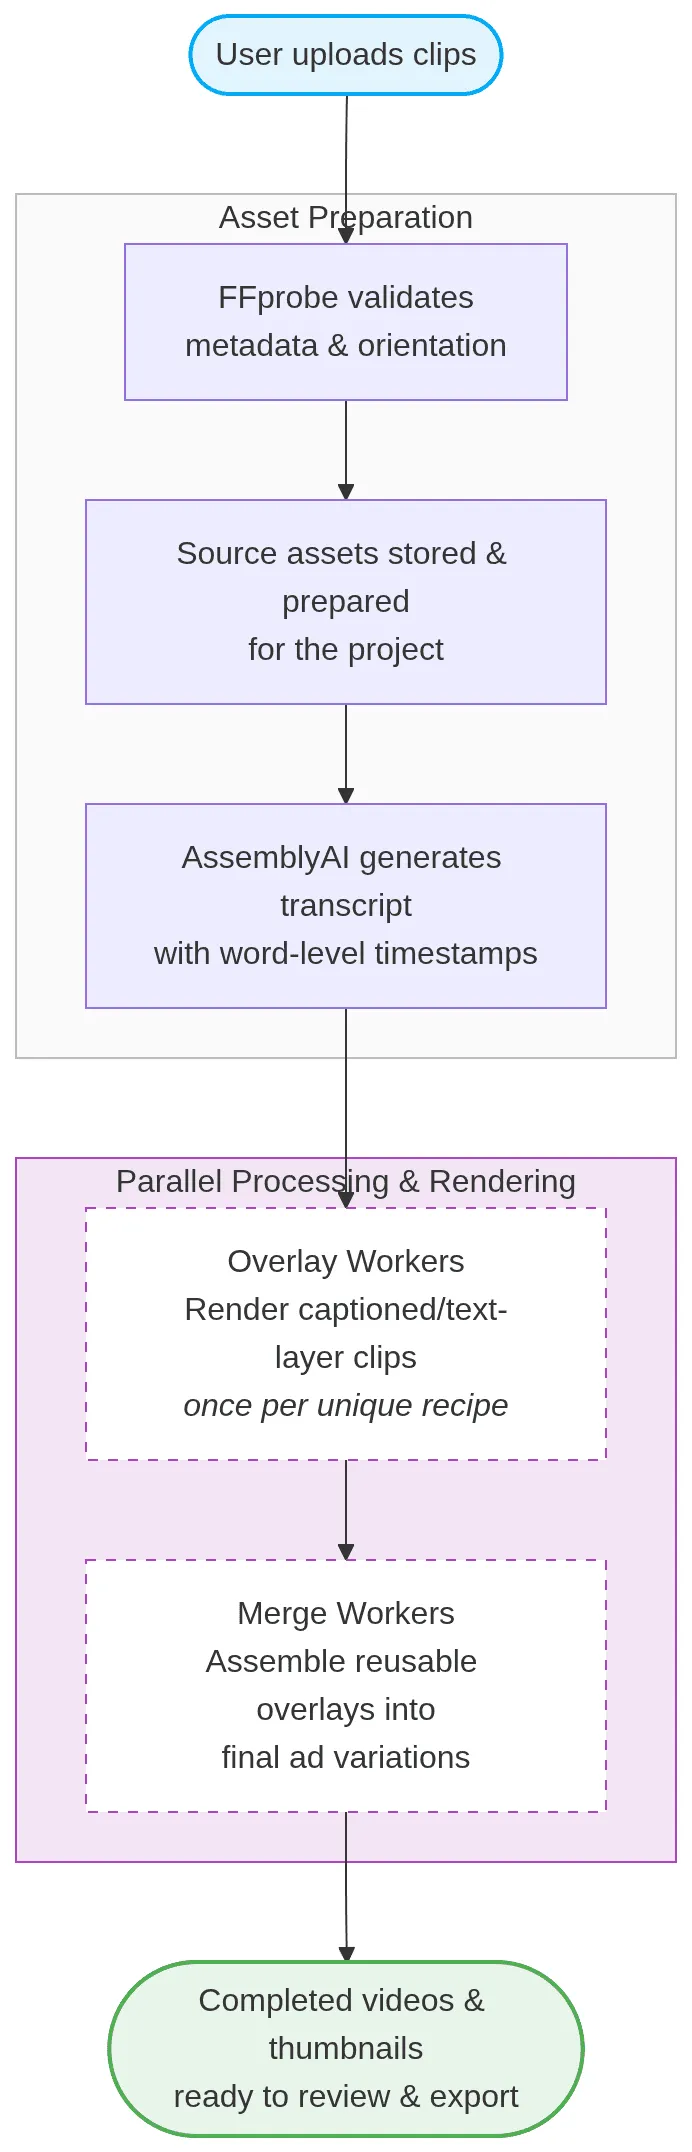
1. FFprobe는 프로젝트 시작 전에 잘못된 입력을 걸러냅니다.
Adstacker가 업로드된 클립을 프로젝트에 커밋하기 전에, 각 파일에 대해 경량 미디어 검사 도구인 FFprobe를 실행합니다. 우리는 안정적인 출력을 위해 중요한 다음 세부 정보를 읽습니다:
- 실제 비디오 스트림이 존재합니다.
- 길이가 프로젝트의 허용 범위 내에 있습니다.
- 유효 해상도가 최소 품질 기준을 충족하고 설정된 최대값을 초과하지 않습니다.
- 프레임 속도가 타이밍 계산에 사용 가능합니다.
- 디스플레이 방향이 올바릅니다. 여기에는 픽셀 치수보다 메타데이터에 회전 정보가 있는 휴대폰 비디오도 포함됩니다.
이것은 조기 실패(fail-fast) 게이트입니다. 에셋이 신뢰할 수 있는 광고를 생성하지 못할 경우, Rendering이 시작되기 전에 제작자에게 유용한 메시지가 전달됩니다. 또한 프로젝트에 대해 제한된 기본 해상도를 선택할 수 있게 하여, 다운스트림 작업자들이 모든 원본 소스 크기를 개별적으로 처리하는 대신 예측 가능한 캔버스에서 작업하도록 합니다.
2. AssemblyAI는 음성을 사용 가능한 자막 타이밍으로 변환합니다.
자막을 사용하는 프로젝트의 경우, 우리는 원본 오디오를 AssemblyAI를 통해 보내고 단순한 텍스트 블록 이상의 것을 받습니다. 즉, 시작 및 종료 타임스탬프가 있는 개별 단어를 받습니다. 이러한 타임스탬프는 음성 언어와 시각적 타이밍 사이의 다리 역할을 합니다.
우리는 타이밍을 초 단위로 정규화하고, 프로젝트의 목표 프레임 속도로 프레임으로 변환하며, 단어들을 짧은 자막 청크(chunks)로 그룹화합니다. 이 그룹화는 의도적인데, 의미 있는 일시 정지 후 또는 현재 줄이 읽기 쉬운 길이에 도달하면 새로운 캡션이 시작됩니다. 또한 인접한 청크들을 클램프(clamp)하여, 원본 단어 타이밍이 겹치더라도 어떤 프레임에서도 하나의 청크만 보이도록 합니다.
그 결과는 비디오에 붙여넣은 일반적인 스크립트가 아니라 간결하고 프레임 인지(frame-aware)적이며 선택된 시각적 스타일에 맞는 자막 데이터입니다.
3. 공유 오버레이를 한 번 렌더링한 다음 재사용합니다.
크리에이티브 확장의 핵심은 중복 작업을 피하는 것입니다. Adstacker 프로젝트는 동일한 Hook 클립을 여러 Body 클립, CTA, 텍스트 레이어 및 자막 스타일과 결합할 수 있습니다. 우리는 캡션이 추가되거나 텍스트 레이어가 있는 세그먼트를 해당 세그먼트를 사용하는 모든 최종 조합마다 한 번씩 렌더링하는 대신, 각 고유한 '레시피'마다 한 번씩 렌더링합니다. 이는 저희 포트폴리오에 있는 단편 비디오 제작 플랫폼인 Ssemble을 위해 구축한 자동 캡션 생성 방식과 유사합니다.
오버레이 작업자는 준비된 원본 비디오, 목표 화면 비율, 사용자 지정 텍스트 레이어 및 자막 청크를 받습니다. 일관된 캔버스에 시각적 처리를 렌더링하고 완성된 오버레이를 재사용 가능한 에셋으로 저장합니다. 최종 Merge 단계는 올바른 Hook, Body 및 CTA 오버레이를 선택하고 완성된 영상을 조립합니다.
이러한 분할은 두 가지 실질적인 이점을 제공합니다:
- 재사용은 렌더링 작업을 줄입니다. 많은 조합이 동일한 구성 요소를 공유할 때.
- 독립적인 재시도를 통해 하나의 오버레이 또는 하나의 최종 Merge에서 발생한 실패를 완료된 작업을 폐기하지 않고 수정할 수 있습니다.
실제 사례: 한 번의 제품 촬영으로 수십 개의 테스트 가능한 광고를 제작
한 스킨케어 브랜드가 Hook 세 개, 제품 시연 두 개, 그리고 CTA 두 개를 업로드한다고 상상해 보십시오. 또한 두 가지 자막 스타일을 선택합니다. 크리에이티브 가능성은 빠르게 증가하지만, 여러 최종 비디오는 동일한 원본 세그먼트와 캡션 처리를 재사용합니다.
Adstacker는 처음에 7개의 모든 클립을 유효성 검사하고, 세로 방향 메타데이터를 고려하며, 각 음성 세그먼트로부터 시간 기반 자막 청크를 생성합니다. 그 다음 필요한 각 오버레이를 한 번만 생성합니다. 최종 조합이 조립될 때, 시스템은 준비된 이 조각들을 반복적으로 다시 생성하는 대신 재사용합니다.
브랜드는 일관된 테스트 준비 완료 광고 세트를 얻는 반면, Pipeline은 이를 생성하는 데 필요한 최소한의 작업만 수행합니다.
안정적인 크리에이티브 볼륨을 위해 구축되었습니다.
Adstacker에서 비디오 처리는 하나의 불투명한 '렌더링' 버튼이 아닙니다. 이는 소스 유효성 검사, 음성 이해, 재사용 가능한 레이어 Rendering, 그리고 최종 크리에이티브 조립이라는 일련의 집중적인 단계입니다. 이러한 구조는 업로드 시 품질을 보호하고, 캡션 동기화를 유지하며, 낭비 없이 다양한 변형을 확장할 수 있도록 돕습니다. 이는 탄력적이고 컨테이너화된 워크로드를 위해 구축된 Cloud Infrastructure에서 실행됩니다.
비디오 에셋을 업로드하고, 테스트하고 싶은 크리에이티브 구성 요소를 선택한 다음, Adstacker가 백그라운드에서 프로덕션 Pipeline을 처리하도록 하세요.
Technology stack: NestJS · FFprobe · AssemblyAI · AWS S3 · AWS ECS Fargate · Remotion · FFmpeg · MongoDB
저희 팀의 다른 글 읽기